Der rzfz.ai Stack — der integrierte Open-Source-Stack für lokale KI-Infrastruktur — bündelt kuratierte Open-Source-Module als Docker-Compose-Container, hinter Caddy als einzigem extern erreichbaren Eintrittspunkt und Authentik SSO, auf der rzfz.ai Box, Ihren eigenen Ubuntu-26.04-Servern oder in der Cloud.
StackMap
Die Stack Map
Vom Reverse Proxy bis zu den Agents — der komplette rzfz.ai Stack live aus den Daten, gruppiert nach Layer. Kachel anklicken, fokussieren oder darauf tippen für Details.
von razzfazz.ai GmbH entwickelt
Experimentell — neu im Stack und noch nicht lange im Feldeinsatz: funktionsfähig, aber möglicherweise noch fehlerhaft
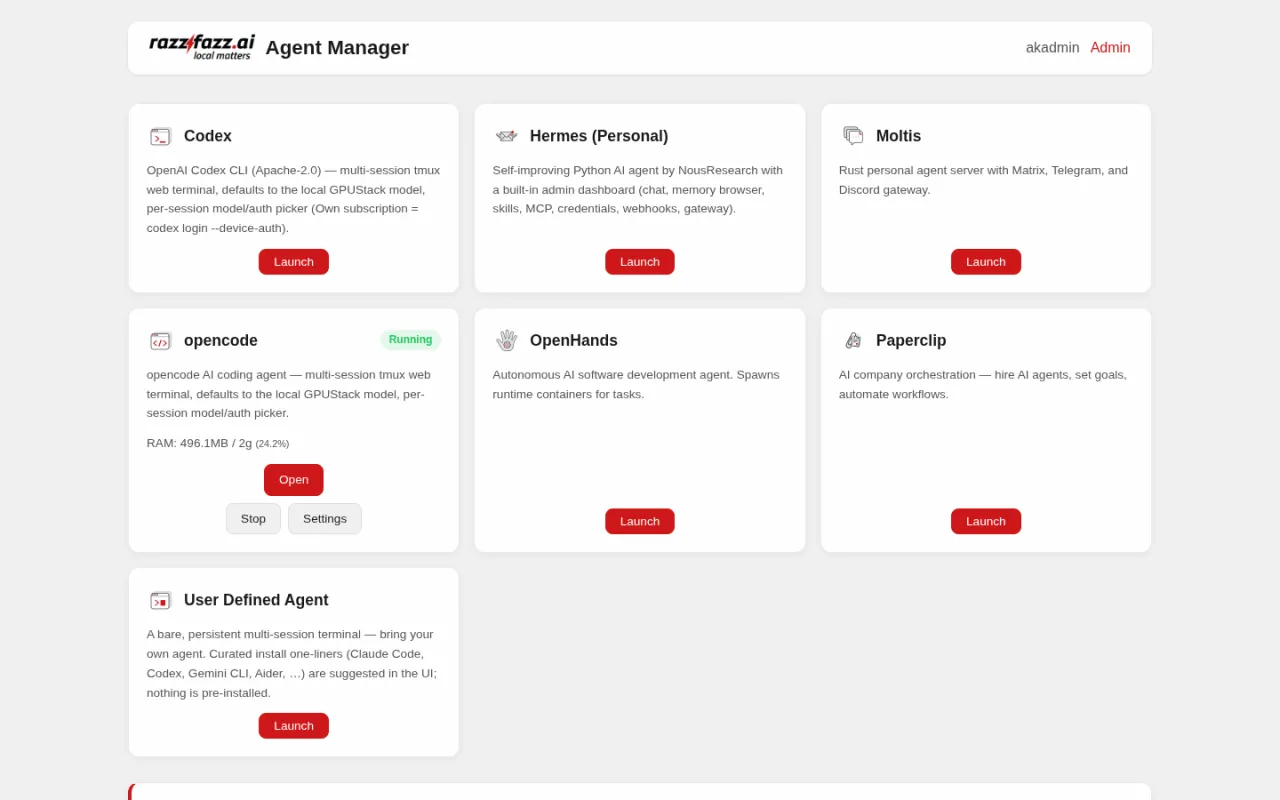
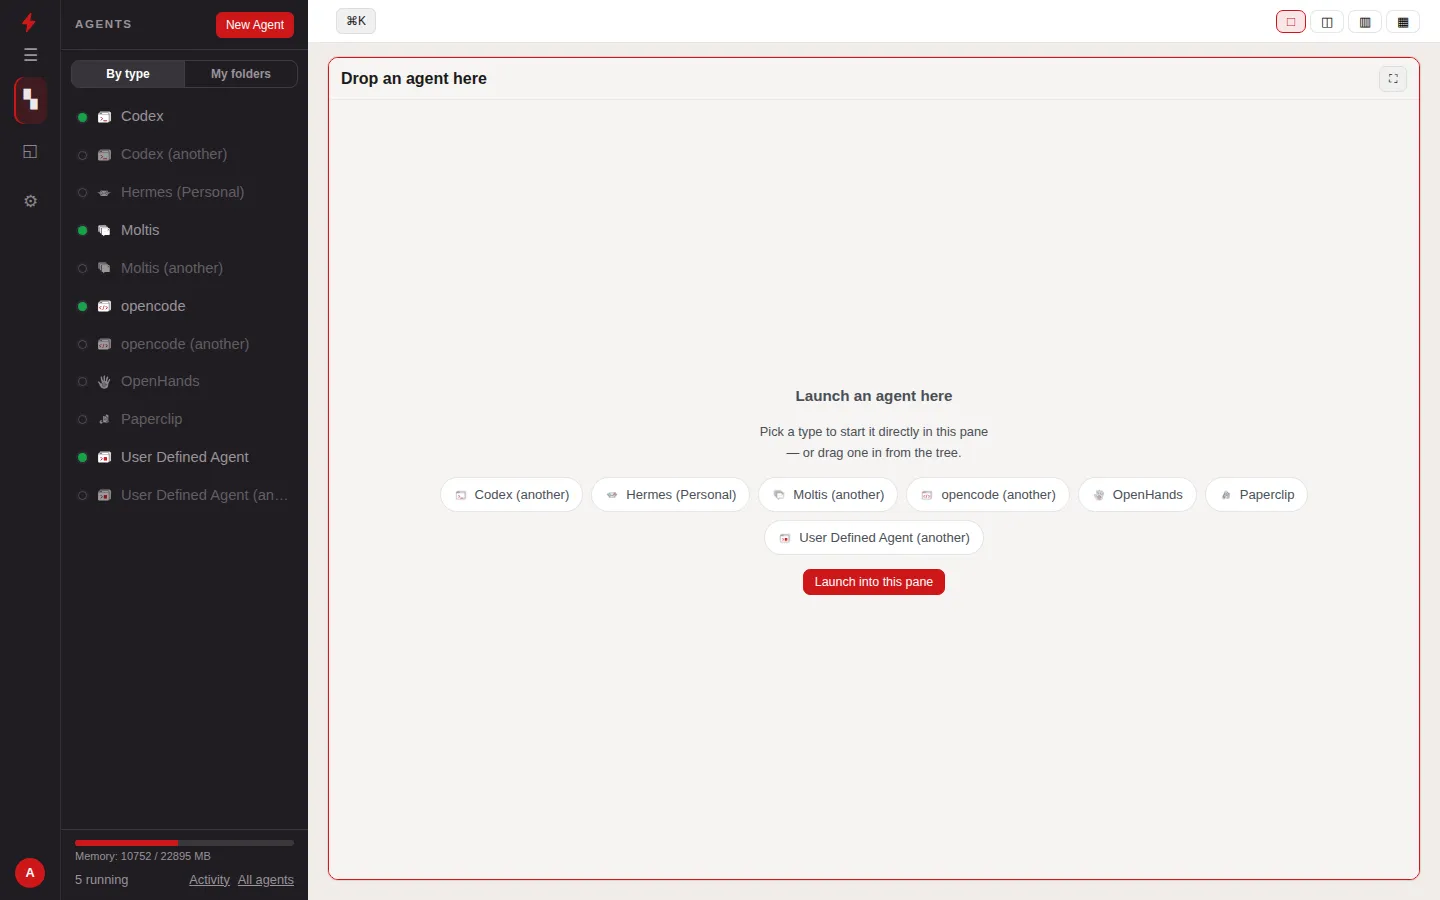
Der Agent-Manager ist der Orchestrator für die persönlichen KI-Agenten der Box. Angemeldete Nutzer starten daraus ihre eigenen, voneinander isolierten Agent-Container — jeder auf einer eigenen Adresse, mit eigenen persistenten Volumes und mit Kontingenten, die den Ressourcenverbrauch je Nutzer begrenzen. Die Routen werden dynamisch bei Caddy registriert, untätige Agenten werden automatisch gestoppt und übrig gebliebene Instanzen aufgeräumt. Administratoren legen fest, welche Agenten-Typen zur Verfügung stehen und welche Kontingent-Stufen es gibt. Das Portal zeigt den Live-Status aller Instanzen, öffnet eine Instanz mit einem Klick und blendet für Coding-Agents die Vorschau des laufenden Entwicklungsservers ein; das rohe Terminal bleibt als letzter Zugang eine Ebene tiefer in den Einstellungen erreichbar. Derzeit als experimentelles Modul enthalten.
Der MCP-Manager ist eine von rzfz.ai entwickelte Verwaltungsoberfläche, über die Nutzer eigene MCP-Integrationen mit ihren persönlichen Zugangsdaten anlegen — verschlüsselt in einem AES-256-GCM-Tresor gespeichert und in einem eigenen Proxy-Container pro Nutzer isoliert. Eine angelegte Integration gibt der Nutzer für seine eigenen Hermes-, Moltis- oder Coding-Agents frei. Derzeit als experimentelles Modul enthalten.
neu im Stack und noch nicht lange im Feldeinsatz — funktionsfähig, aber möglicherweise noch fehlerhaft
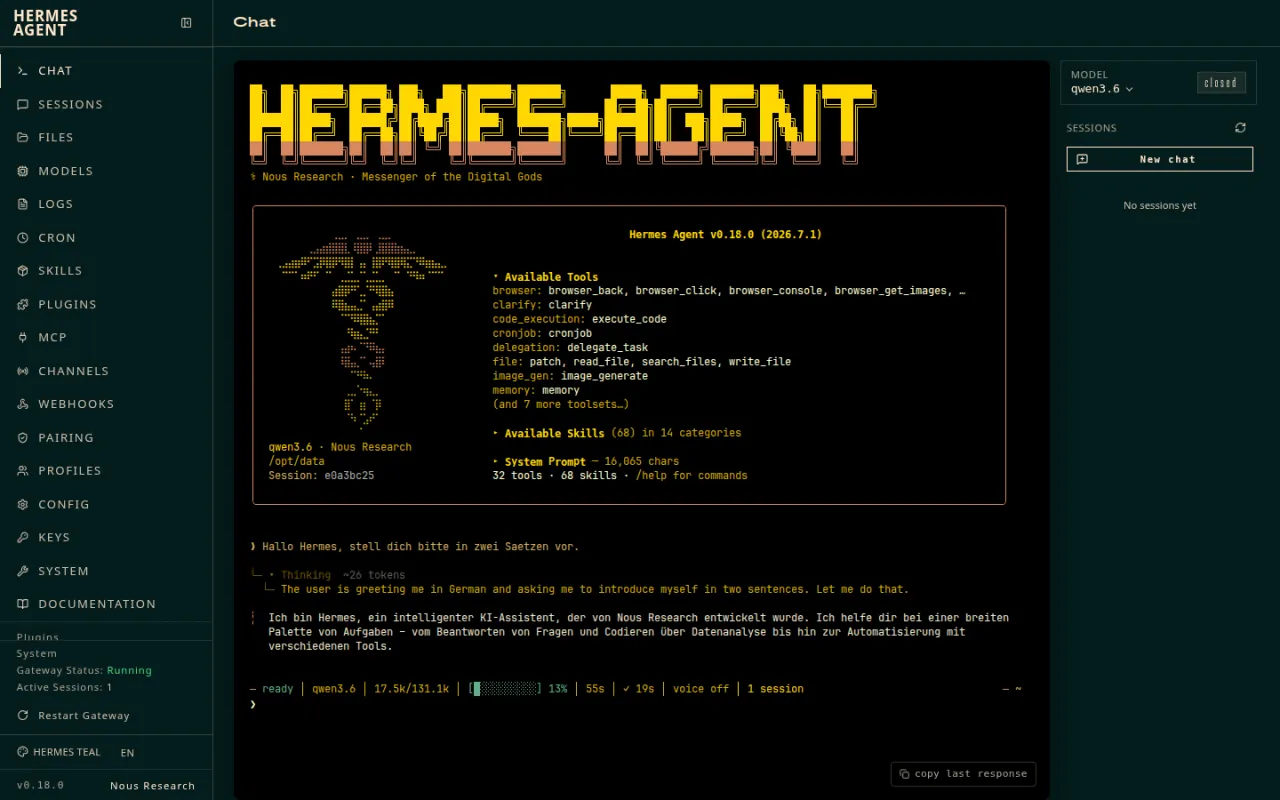
Basis: Hermes von Nous Research — von razzfazz.ai GmbH als Container für den Stack gebaut.
US
Apache-2.0
Hermes ist ein selbstverbessernder Python-Agent von Nous Research, den rzfz.ai als Container mit persistentem Gedächtnis, über 30 Werkzeugen und einem MCP-Client betreibt. Im Stack provisioniert jeder Nutzer über den Agent-Manager seine eigene Hermes-Instanz samt Hermes-Workspace-Oberfläche zum Durchsuchen von Gedächtnis und Skills. Derzeit als experimentelles Modul enthalten.
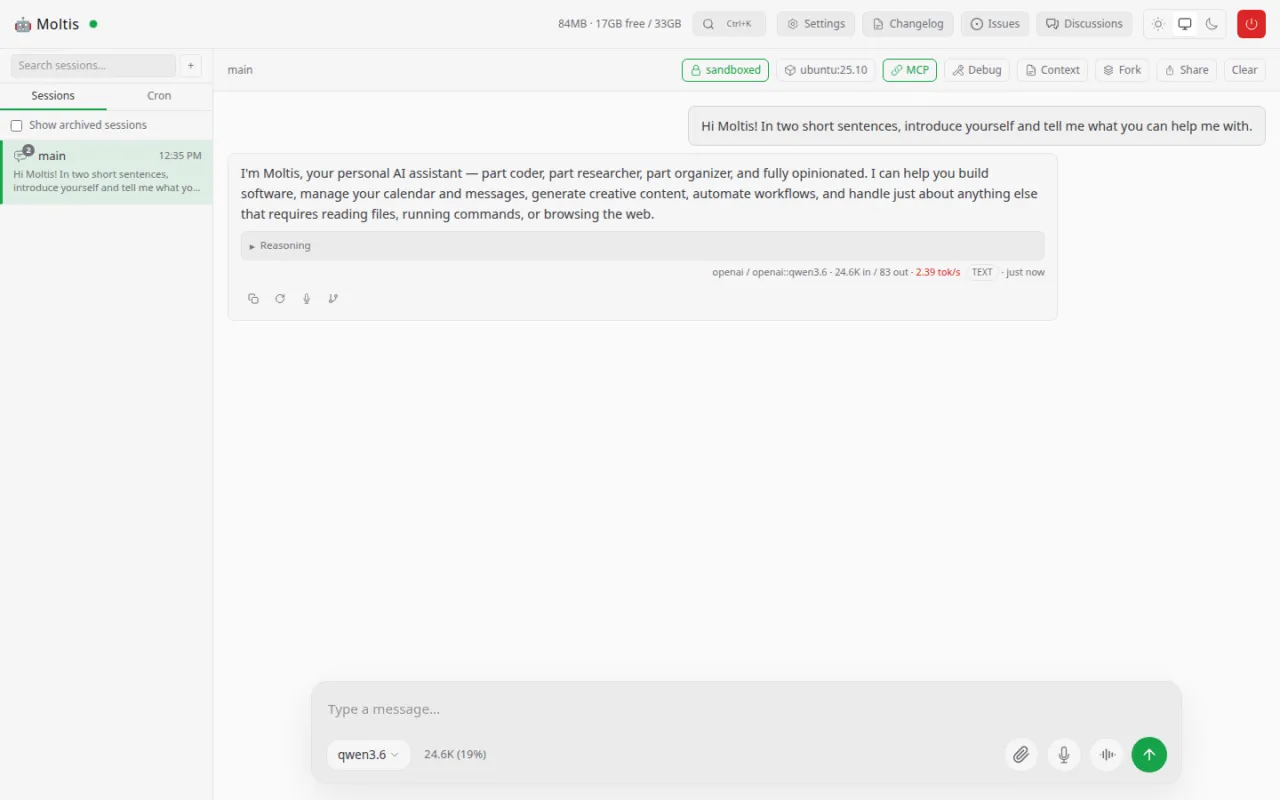
Moltis ist ein in Rust geschriebener persönlicher Agent-Server mit Anbindung an Matrix, Telegram und Discord sowie sandboxed Code-Ausführung, den rzfz.ai als Container betreibt. Im Stack provisioniert jeder Nutzer über den Agent-Manager seine eigene Moltis-Instanz mit persistentem Gedächtnis. Derzeit als experimentelles Modul enthalten.
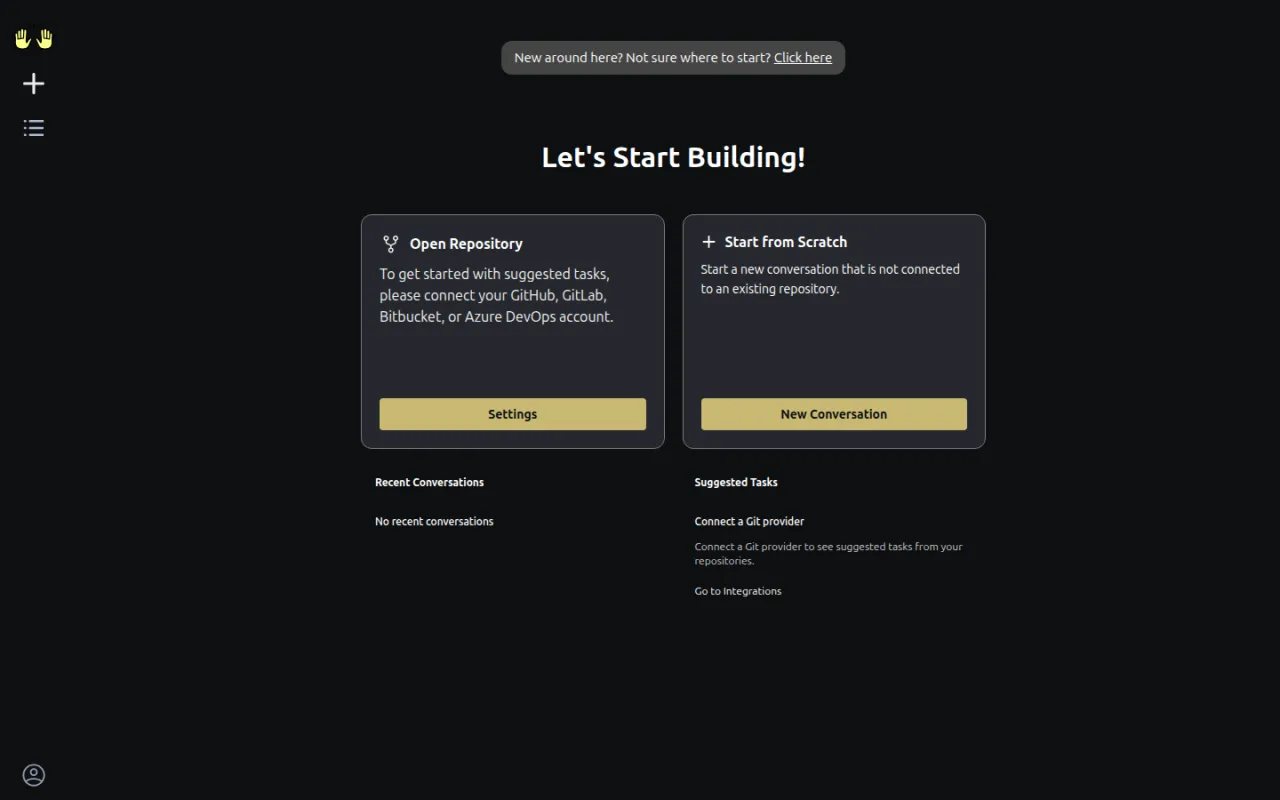
OpenHands ist ein autonomer Coding-Agent, der Code plant, schreibt, ausführt und testet — dazu startet er projektbezogene Sandbox-Container. Im Stack ist es an Gitea für Repositories und Pull Requests sowie an den LLM-Manager für Inferenz angebunden und benötigt Zugriff auf den Docker-Socket. Derzeit als experimentelles Modul enthalten.
Paperclip ist ein Agent-Orchestrator, den rzfz.ai als Container betreibt: Er verteilt Rollen und Ziele an Teams von Agents, weist Aufgaben zu und führt Budgets und ein Audit-Log. Im Stack bindet es Gitea, Infisical und den LLM-Manager ein und befindet sich noch in einem frühen Entwicklungsstadium. Derzeit als experimentelles Modul enthalten.
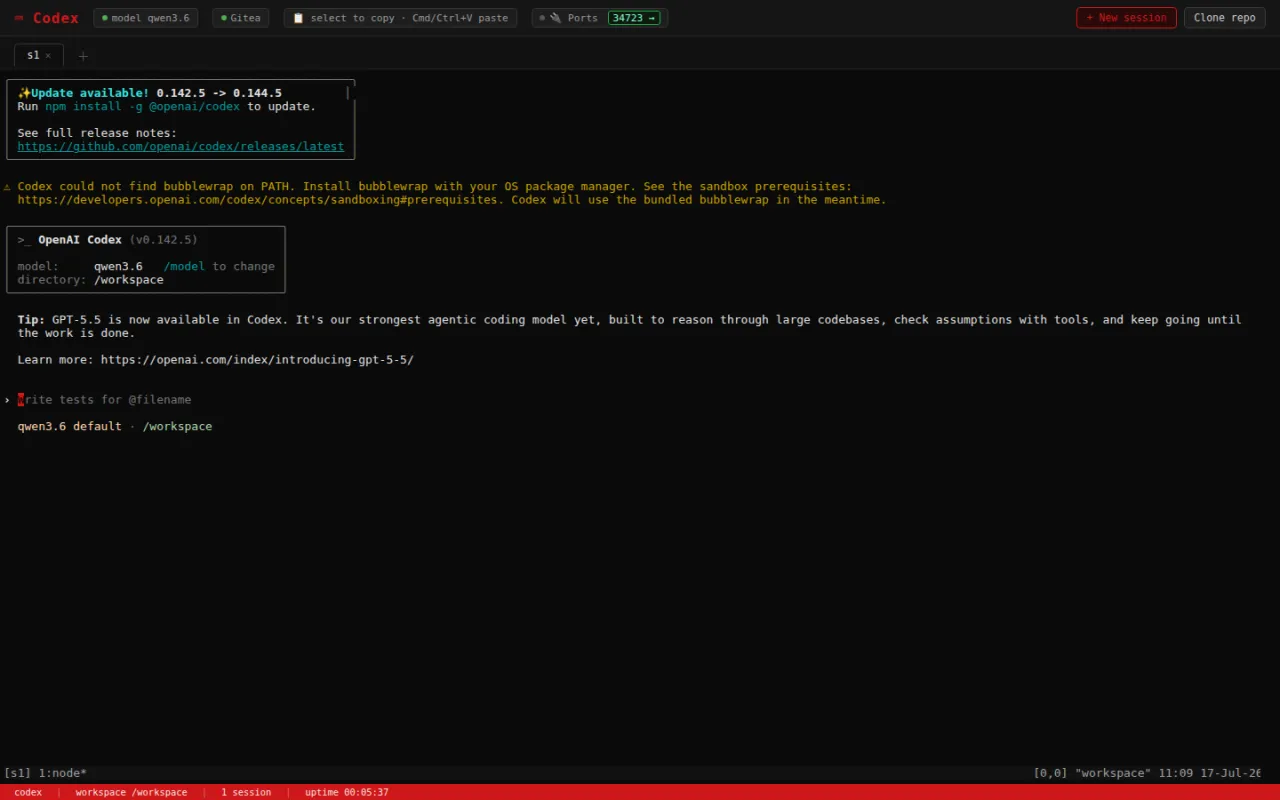
Codex ist ein von OpenAI entwickelter, quelloffener Coding-Agent fürs Terminal. Im Stack läuft er als ein Sandbox per-Nutzer-Container im persistenten Coding-Agents-Workspace, vorverdrahtet gegen die lokalen Modelle des LLM-Managers. Derzeit als experimentelles Modul enthalten.
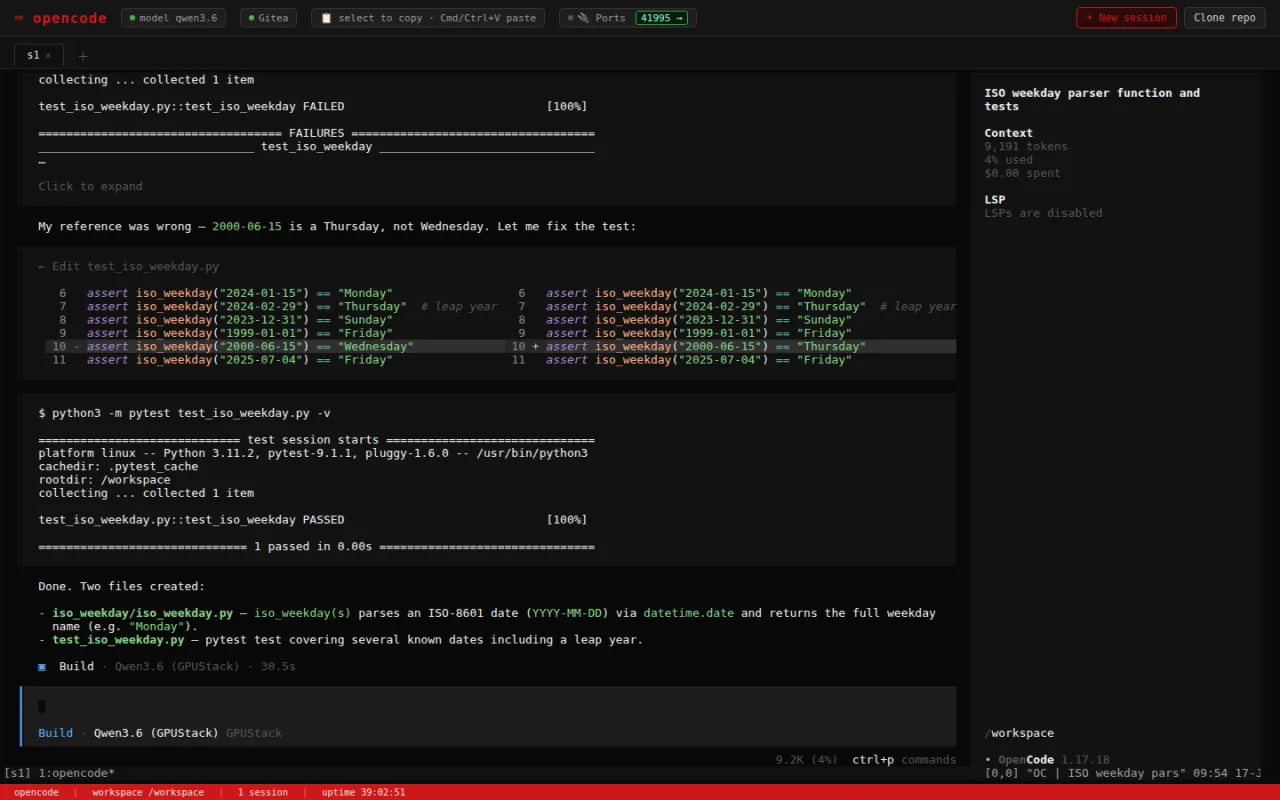
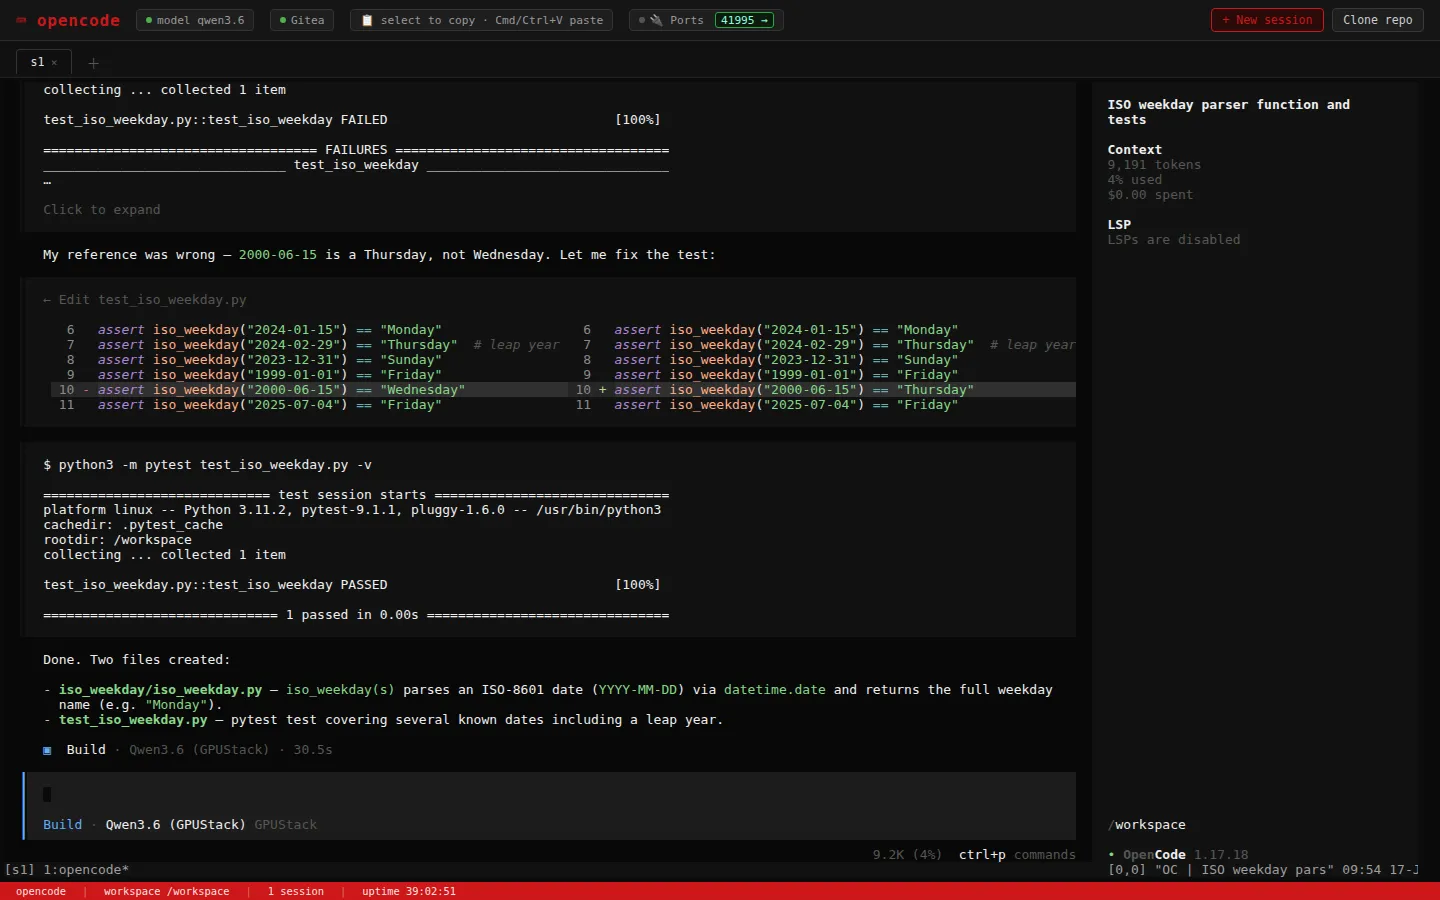
OpenCode ist ein quelloffener KI-Coding-Agent fürs Terminal. Im Stack läuft er als ein Sandbox per-Nutzer-Container im persistenten Coding-Agents-Workspace, vorverdrahtet gegen die lokalen Modelle des LLM-Managers. Derzeit als experimentelles Modul enthalten.
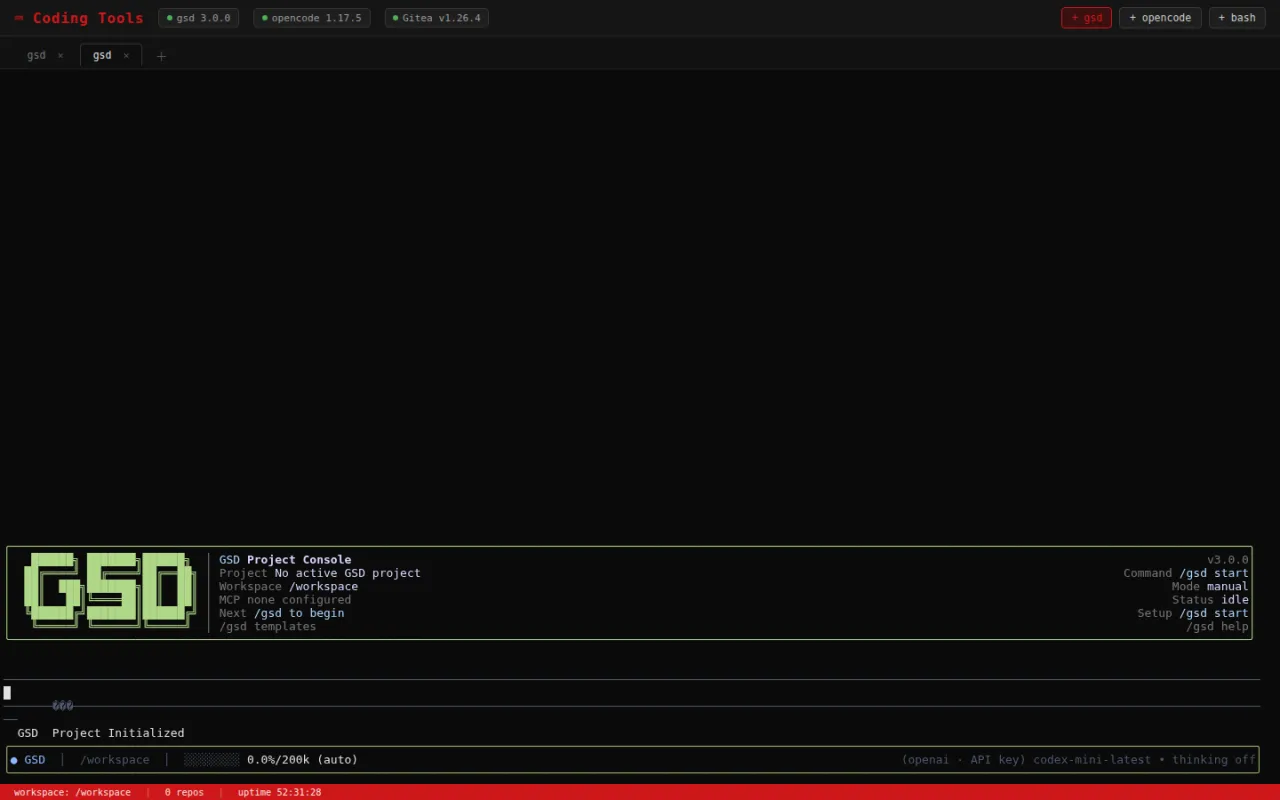
gsd-pi ist ein quelloffenes Werkzeug für spezifikationsgetriebene Entwicklung. Es ist kein eigenes gebautes Image mehr, sondern eine von rzfz.ai empfohlene nutzerdefinierte Installation (`npm i -g @opengsd/gsd-pi`) im persistenten Coding-Agents-Workspace. Derzeit als experimentelles Modul enthalten.
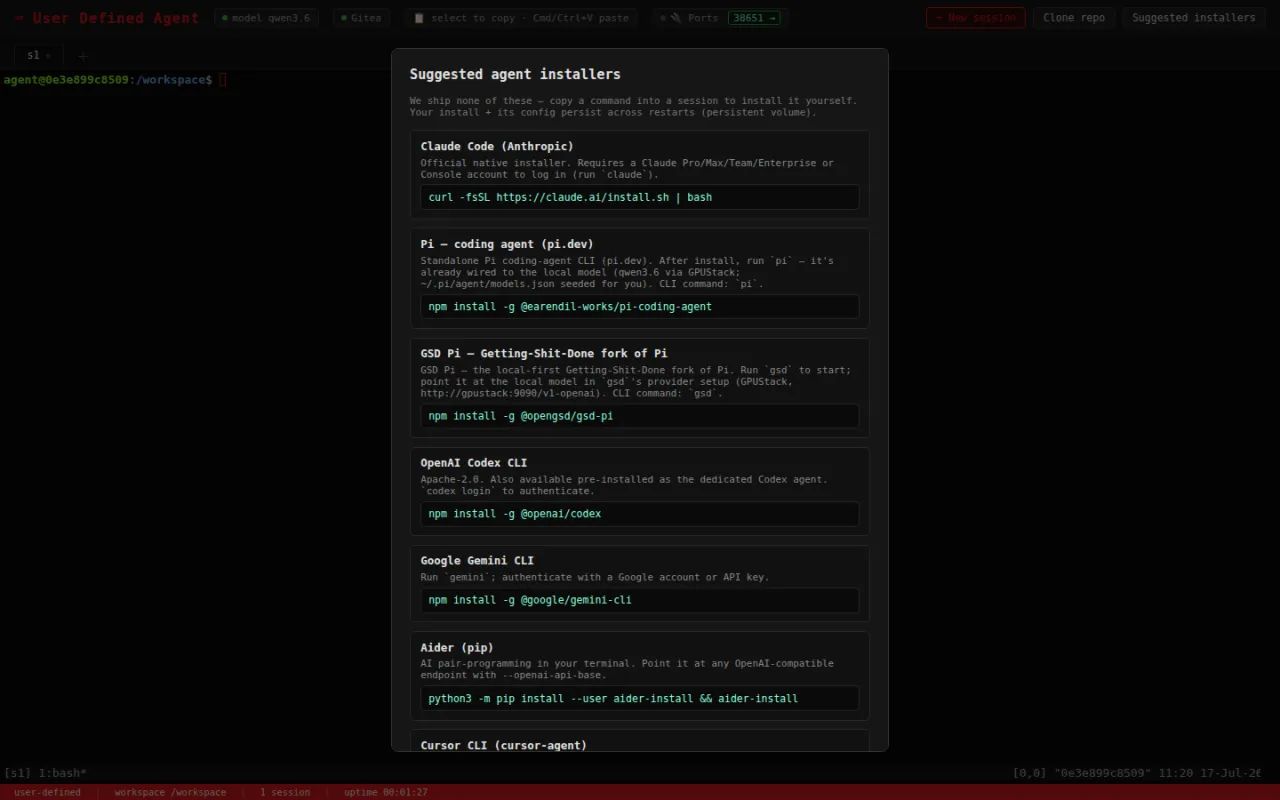
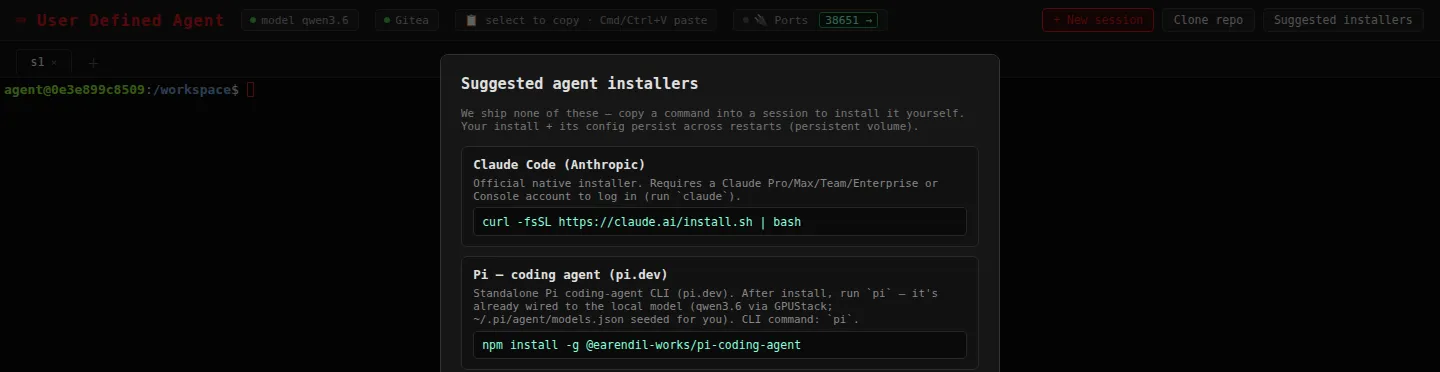
Der Coding-Agents-Workspace bündelt neben Codex und OpenCode auch eine „User Defined"-Variante: ein eigener, von rzfz.ai entwickelter Container mit Terminal und geschützter Sandbox, in dem Nutzer einen beliebigen Coding-Agent ihrer Wahl installieren — etwa Gemini CLI oder Claude Code — und zentral rund um die Uhr betreiben, statt eines vorkonfigurierten Werkzeugs. Neu in 2026.07-ga. Derzeit als experimentelles Modul enthalten.
Gotenberg konvertiert HTML, Markdown und Office-Dokumente per Chromium und LibreOffice in PDF über eine REST-API. Im Stack dient es als Konvertierungs-Backend für Paperless-ngx und ist auch aus Dify-Workflows heraus nutzbar; es läuft rein intern.
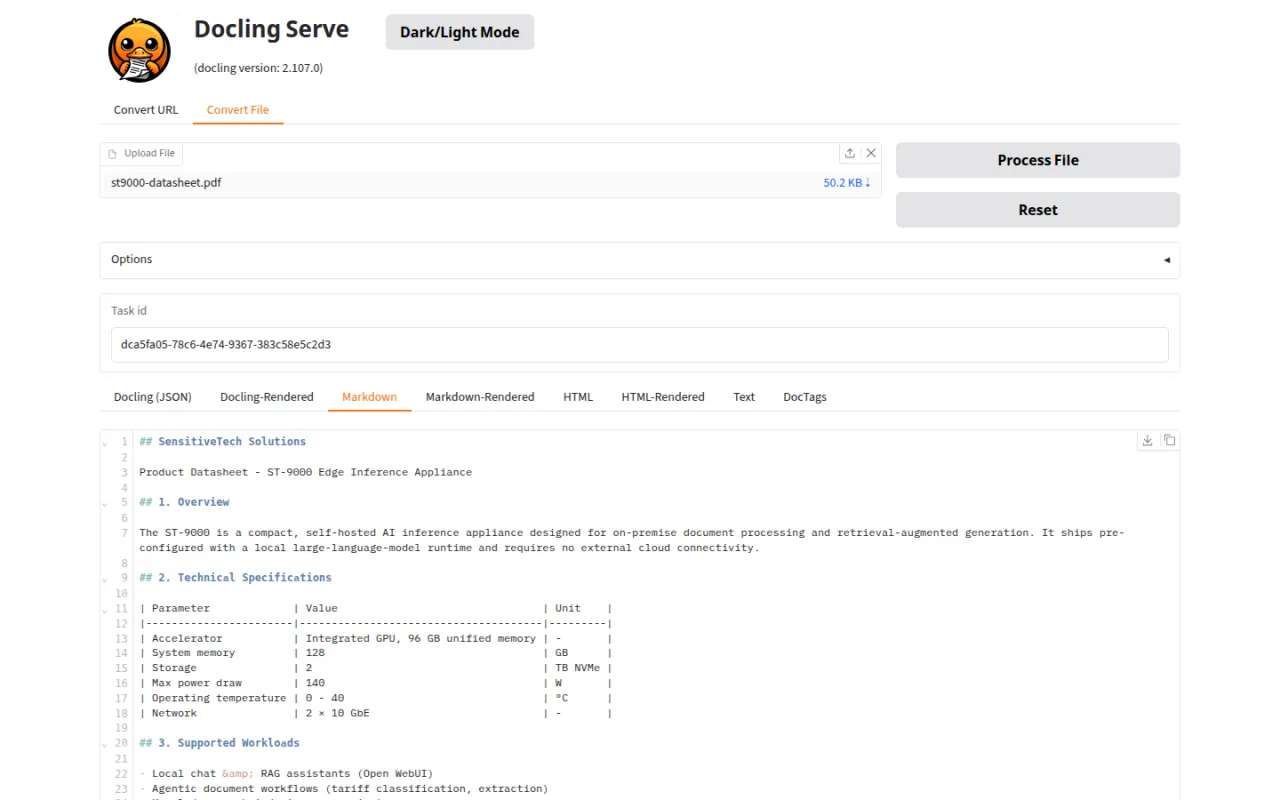
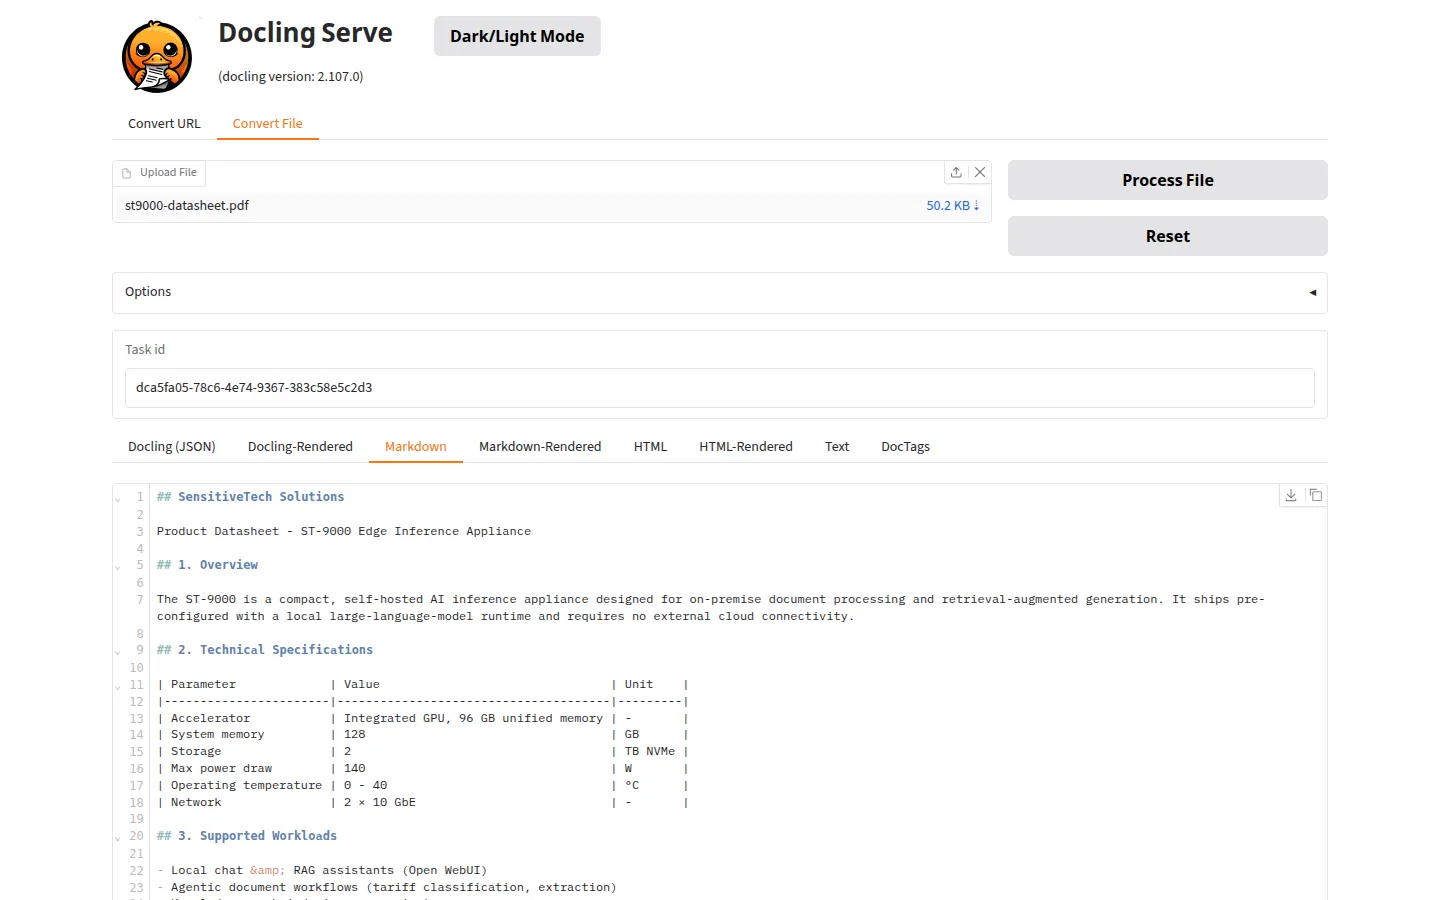
Docling vereinfacht die Dokumentenverarbeitung: Es parst unterschiedlichste Formate — einschließlich fortgeschrittenem PDF-Verständnis — und fügt sich nahtlos in das generative-KI-Ökosystem ein. Es unterstützt unter anderem PDF, DOCX, PPTX, XLSX, HTML sowie Bildformate als Eingabe und exportiert nach Markdown, HTML oder JSON. Für agentische KI bringt es Plug-and-play-Integrationen mit LangChain, LlamaIndex, CrewAI und Haystack mit und läuft als API- oder MCP-Server. Derzeit als experimentelles Modul enthalten.
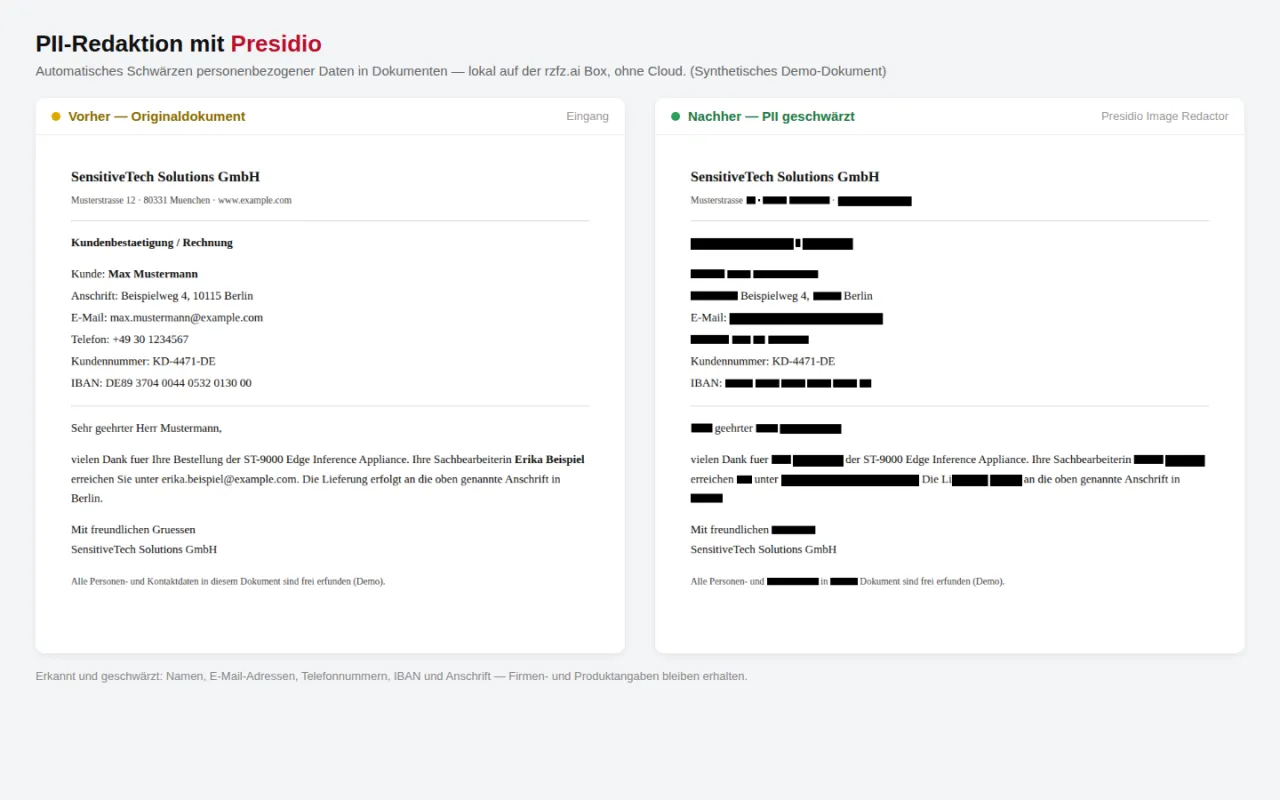
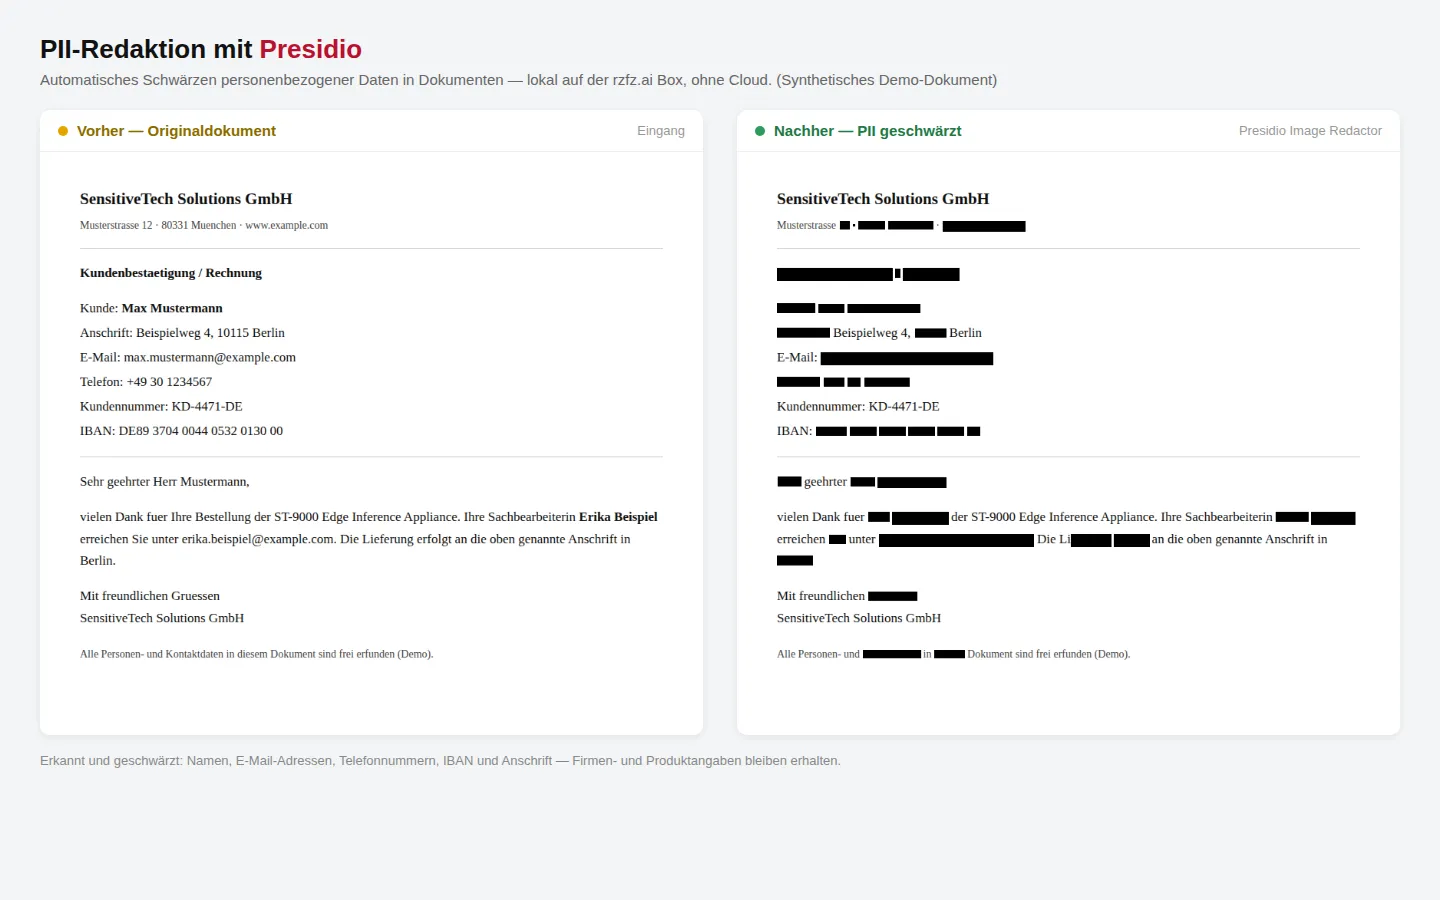
Presidio ist ein ursprünglich von Microsoft gestartetes, inzwischen an die Data Privacy Stack-Organisation übergegangenes Werkzeug zur PII-Erkennung: Analyzer, Anonymizer und Image Redactor erkennen und schwärzen über 30 Arten personenbezogener Daten in Text und Bildern. Im Stack läuft es rein intern als Vorverarbeitungsschritt, bevor Dokumente an andere Module weitergereicht werden. Derzeit als experimentelles Modul enthalten.
Apache Tika extrahiert Text, Metadaten und Sprache aus über tausend Dateiformaten. Im Stack läuft es rein intern als Extraktions-Backend für Paperless-ngx. Derzeit als experimentelles Modul enthalten.
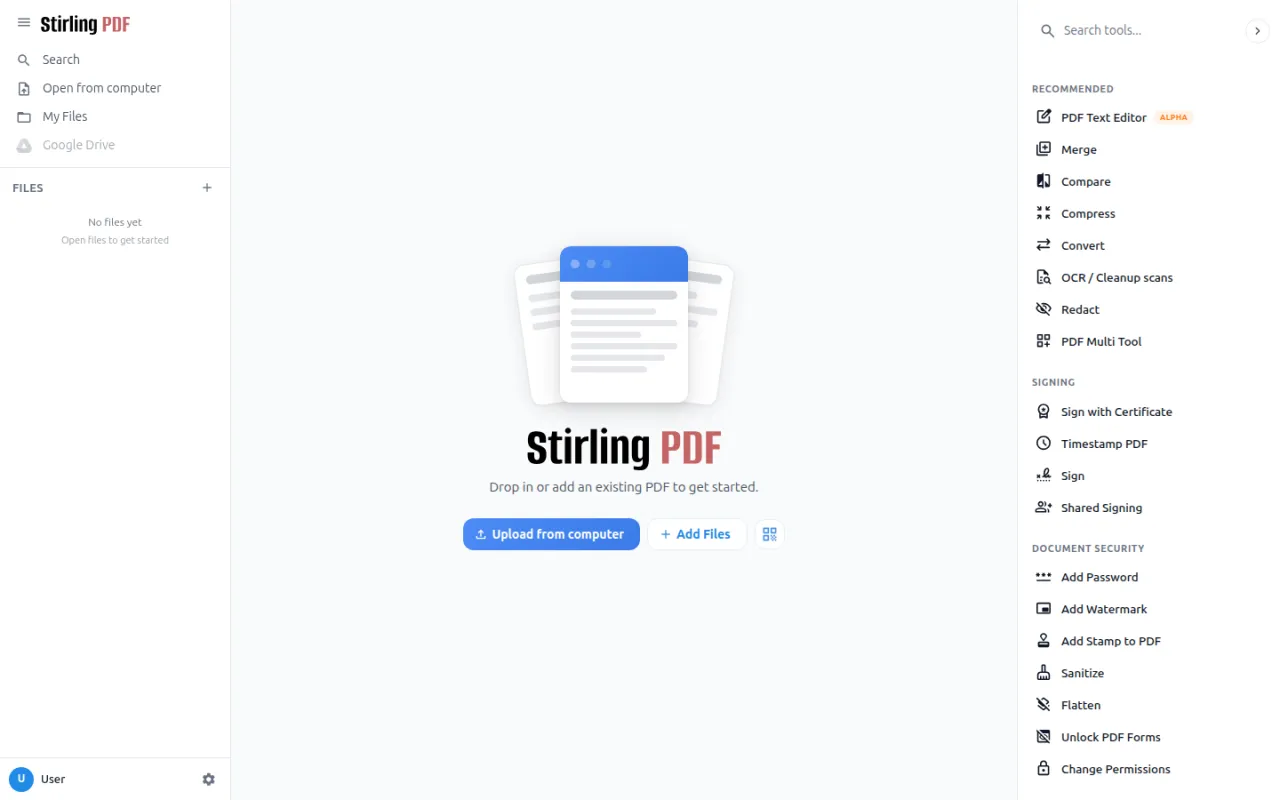
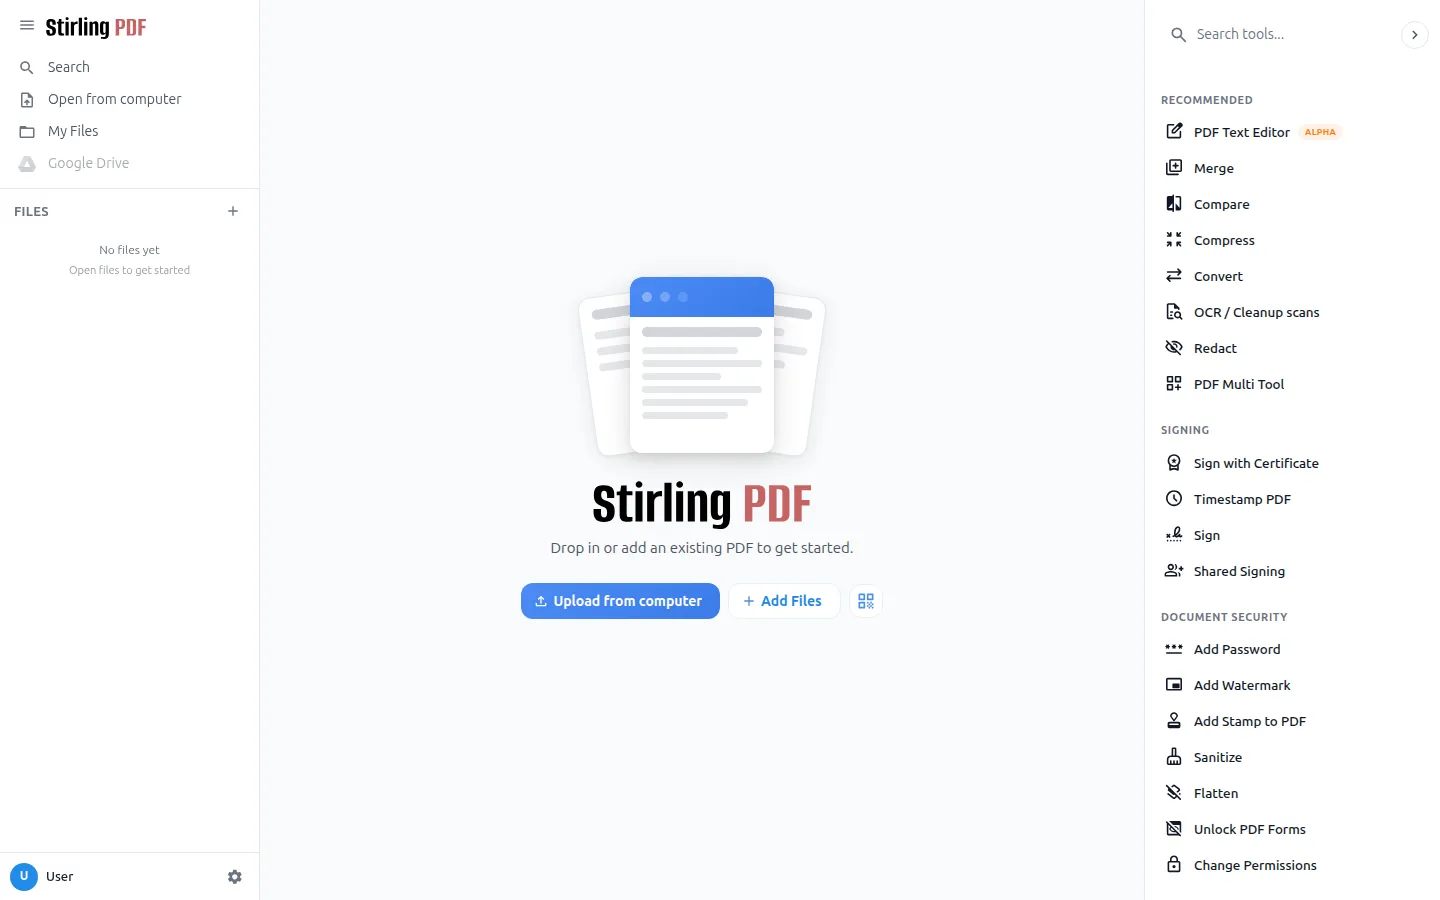
Stirling PDF ist eine leistungsfähige, quelloffene PDF-Bearbeitungsplattform, die als Desktop-App, im Browser oder auf eigenen Servern mit privater API läuft. Sie bringt über 50 PDF-Werkzeuge für Bearbeiten, Zusammenführen, Teilen, Signieren, Schwärzen, Konvertieren, OCR und Komprimieren mit sowie Enterprise-Funktionen wie Single Sign-on und Auditing. Derzeit als experimentelles Modul enthalten.
Crawl4AI ist ein auf LLMs zugeschnittener Web-Crawler, der Seiteninhalte per Chromium/Playwright abruft und als sauberes Markdown oder JSON aufbereitet. Im Stack liefert es die inhaltliche Vertiefung von Webinhalten für LightRAG, Cognee, Onyx und Dify — anders als SearXNGs reine URL-Recherche. Derzeit als experimentelles Modul enthalten.
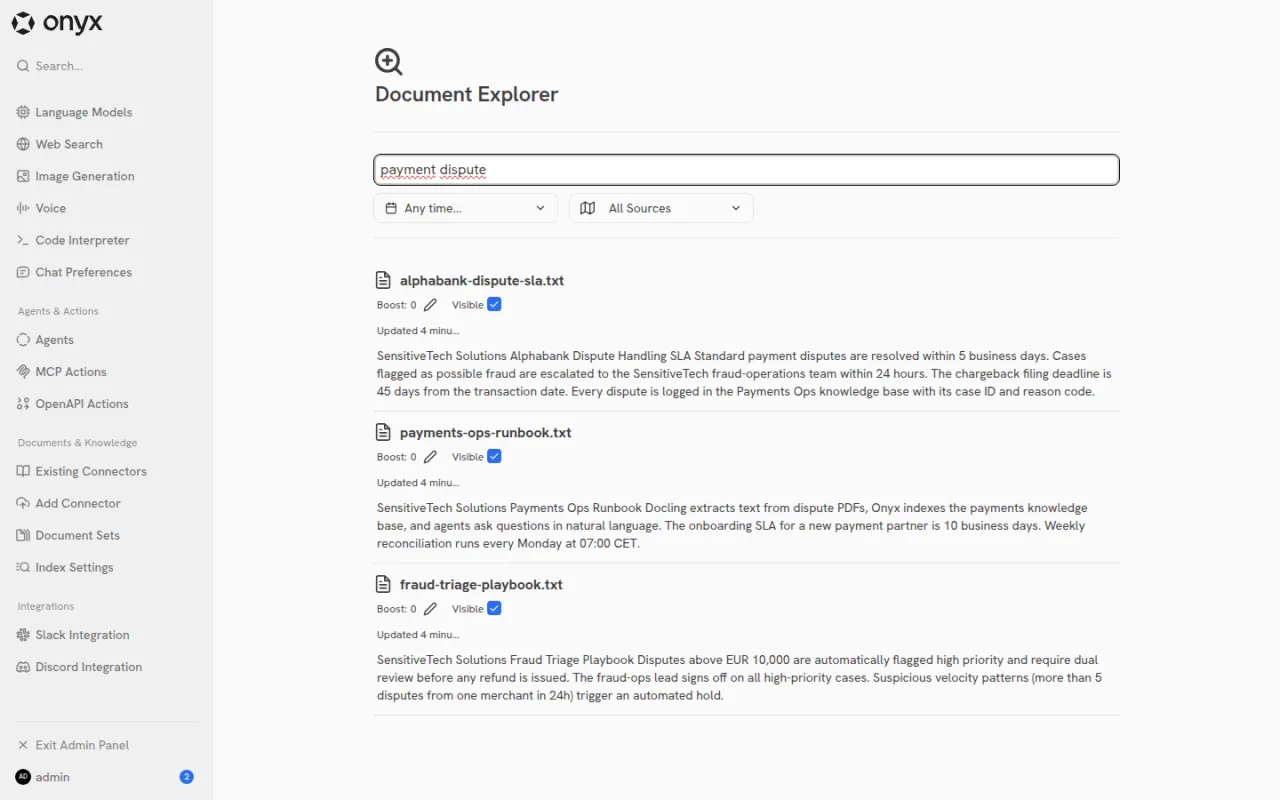
Onyx ist eine Unternehmenssuche mit semantischer Suche und LLM-Antworten über mehr als 40 Konnektoren, mit eigenem Vespa-Suchindex und eigenen Embedding-Servern. Im Stack kann es Gitea und Paperless-ngx als Datenquellen anbinden und ist mit sechs Containern das ressourcenintensivste Modul des Stacks. Derzeit als experimentelles Modul enthalten.
Paperless-ngx macht aus physischen Dokumenten ein durchsuchbares Online-Archiv — kurz: weniger Papier. Es ist der offizielle Nachfolger früherer Paperless-Versionen und wird community-getrieben weiterentwickelt. Derzeit als experimentelles Modul enthalten.
Open WebUI ist eine erweiterbare, funktionsreiche und benutzerfreundliche, selbst gehostete KI-Plattform, die vollständig offline arbeitet. Sie unterstützt verschiedene LLM-Runner wie Ollama und OpenAI-kompatible APIs und bringt eine eigene RAG-Inferenz-Engine mit. Dazu kommen granulare Zugriffskontrollen, Echtzeit-Zusammenarbeit über Channels, persistentes Gedächtnis sowie Sprach- und Video-Funktionen — im Stack ergänzt um Speaches für Spracheingabe und -ausgabe und SearXNG für die Websuche.
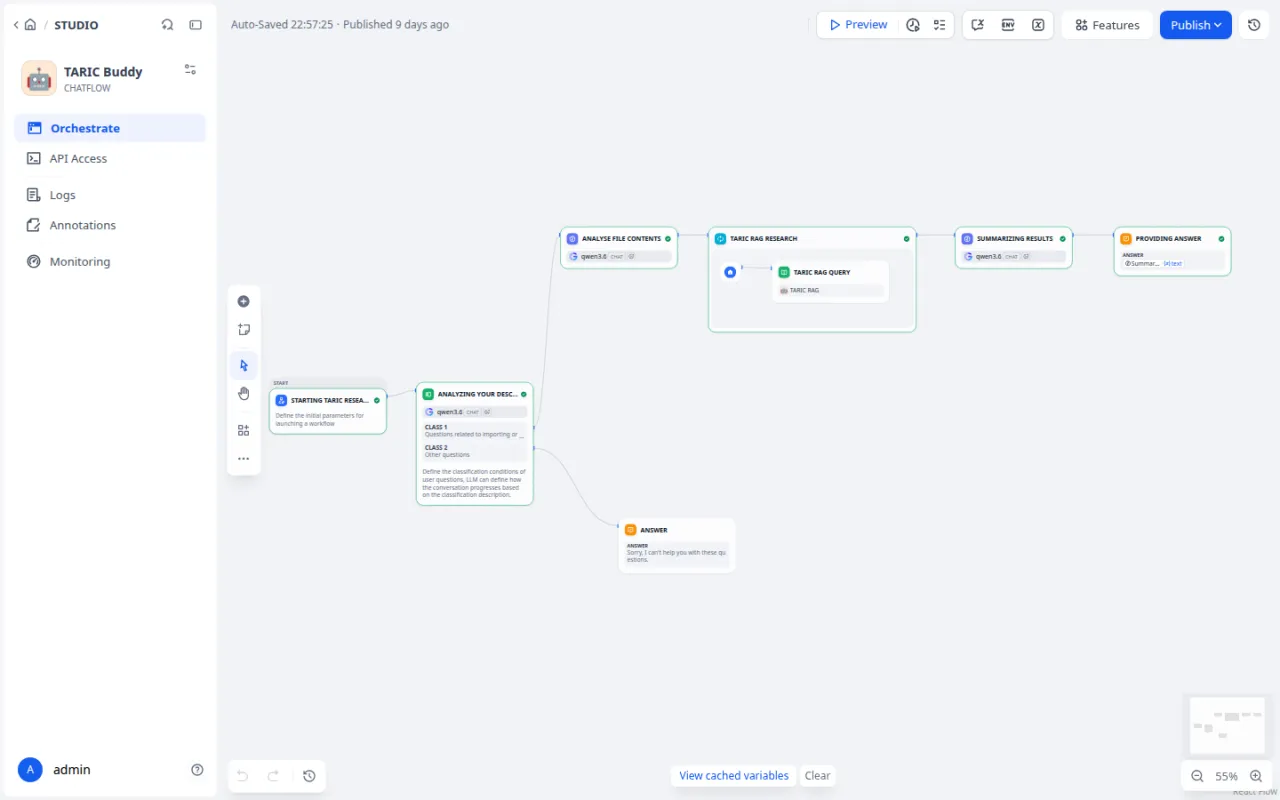
Dify ist eine Open-Source-Plattform zur Entwicklung von LLM-Anwendungen, die mehrere Fähigkeiten in einer Oberfläche bündelt: einen visuellen Workflow-Editor, eine Prompt-IDE, RAG-Pipelines für Dokumenten-Ingestion, Agent-Funktionen mit über 50 eingebauten Werkzeugen sowie LLMOps zur Überwachung produktiver Anwendungen. Sie unterstützt hunderte proprietäre und quelloffene Sprachmodelle; im Stack läuft die selbst gehostete Community Edition gegen den lokalen LLM-Manager, der die Modelle serviert — auf Boxen mit aktiviertem Legacy-Profil auch über GPUStack.
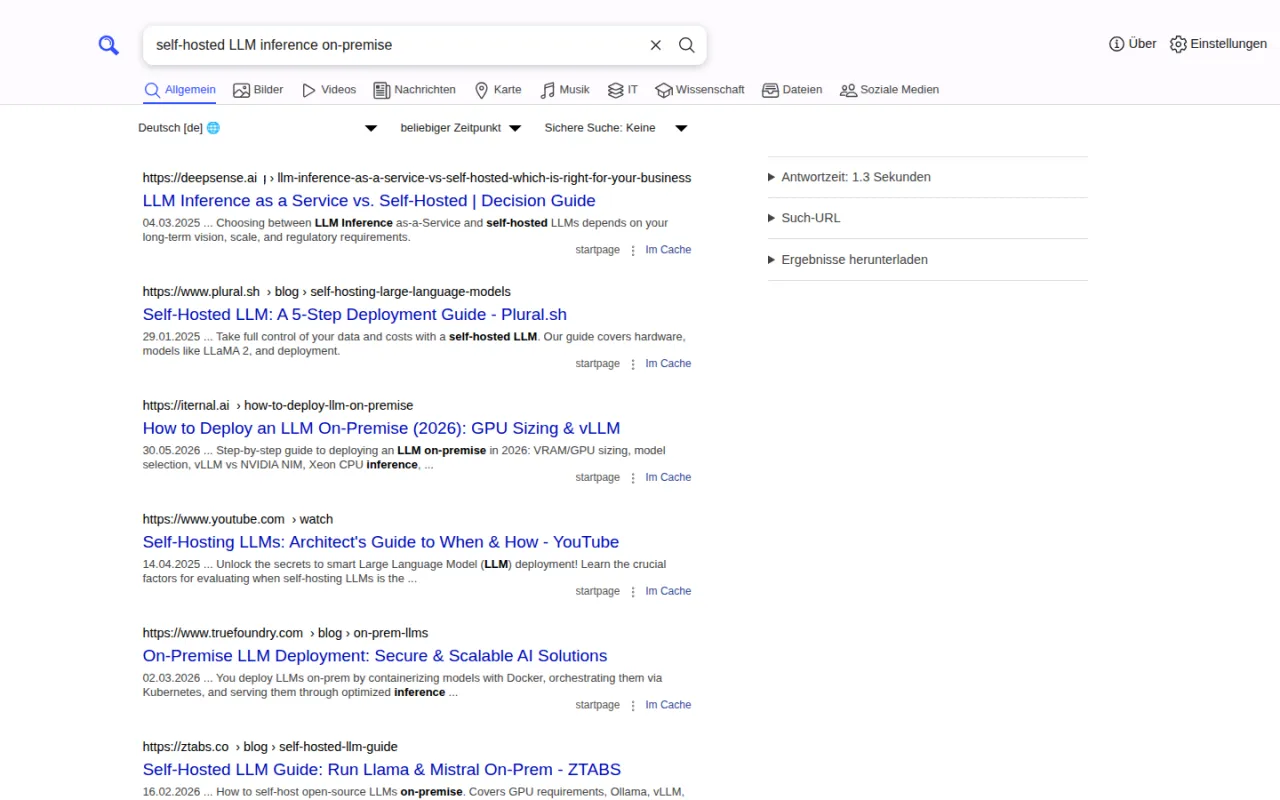
SearXNG ist eine Metasuchmaschine, die Ergebnisse mehrerer Suchdienste zusammenführt, ohne Nutzer zu verfolgen oder zu profilieren. Im Stack dient sie der Webrecherche, zum Beispiel in Open WebUI und in Dify. SearXNG ist quelloffen und steht unter der AGPL-3.0-Lizenz.
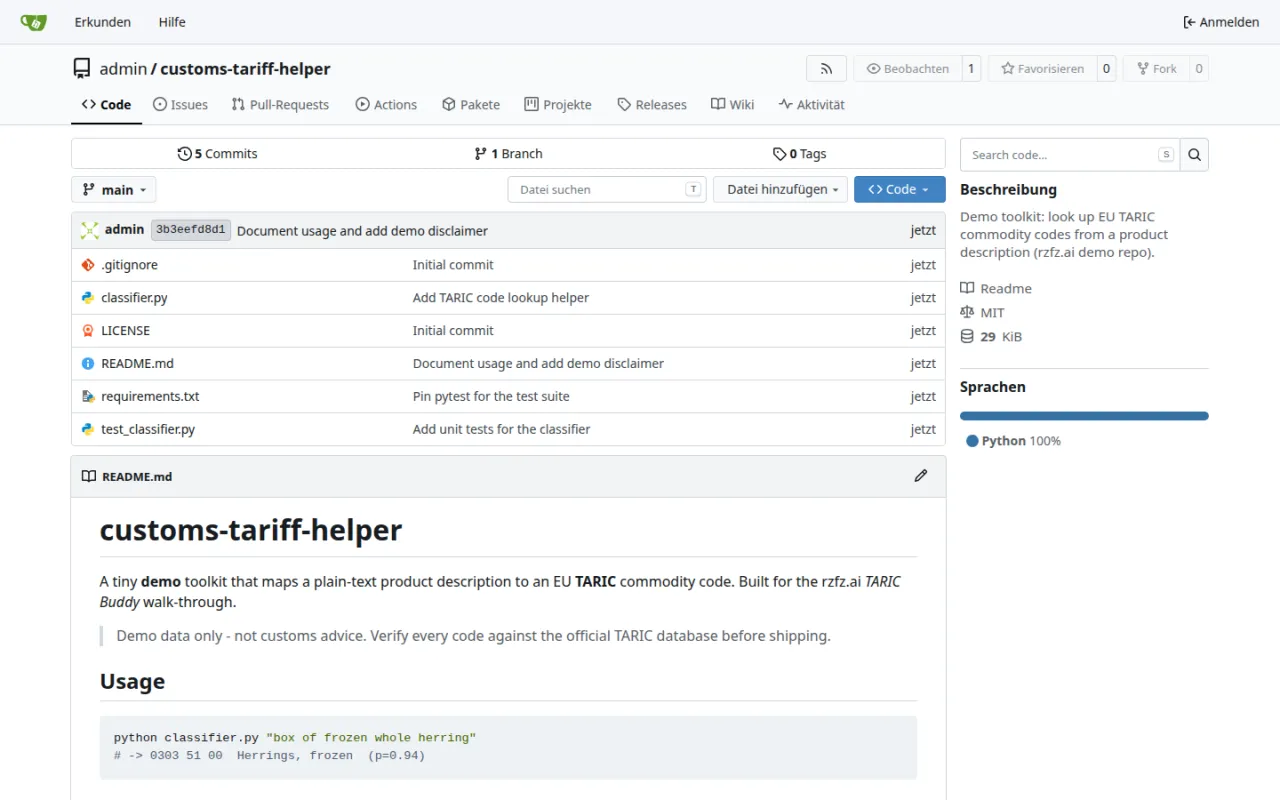
Gitea ist eine in Go geschriebene, selbst gehostete Software-Entwicklungsplattform für einen unkomplizierten All-in-one-Entwicklungsdienst. Sie bündelt Git-Hosting, Code-Review, Issue-Tracking, ein Kanban-Board, Wiki, Team-Zusammenarbeit, eine Paket-Registry sowie CI/CD-Funktionen über Gitea Actions, die GitHub-Actions-Workflows wiederverwenden können. Dank Go läuft Gitea auf zahlreichen Plattformen und Architekturen, von Linux und macOS bis Windows, FreeBSD und OpenBSD.
Matrix ist ein offenes Netzwerk und ein offener Standard für sichere, dezentrale und interoperable Echtzeitkommunikation. Synapse, die im Stack eingesetzte Server-Implementierung, wird von Element als quelloffener Matrix-Homeserver entwickelt und gepflegt. Derzeit als experimentelles Modul enthalten.
Wazuh beschreibt sich selbst als freie, quelloffene Plattform für Bedrohungsprävention, -erkennung und -reaktion. Im Stack läuft es als drei Dauerdienste — Manager, ein Indexer auf OpenSearch-Basis und die Web-Konsole — plus mehrere Einmal-Jobs, die die eigene TLS-PKI und sämtliche Zugangsdaten des Moduls erzeugen; kein Standard-Zugangsdatum aus dem Upstream überlebt die Installation. Ein Agent je Box meldet journald, eine vom Betreiber freigegebene Liste von Container-Logs und Datei-Integritätsereignisse; die Agenten-Aufnahme ist passwortgeschützt und jeder Listener des Managers auf ein Netzsegment eingegrenzt. Der gesamte Zustand liegt im eigenen Indexer, nie in der gemeinsamen Datenbank des Stacks. Die ausgelieferte Zusammenstellung trägt nicht eine einzige Lizenz: der Manager steht unter GPL-2.0, Indexer und Konsole sind OpenSearch-Abkömmlinge unter Apache-2.0. Das Modul ist opt-in, in keinem Preset enthalten und experimentell.
OpenUEM nennt sich selbst ein quelloffenes Unified Endpoint Management, mit dem sich IT-Bestände über Agenten und eine aufgeräumte Weboberfläche verwalten lassen. Im Stack bringt das Modul seine eigene Zertifizierungsstelle und einen NATS-JetStream-Broker mit, über den die Agenten sprechen; die Inventardaten liegen in einer eigenen Datenbank auf der gemeinsamen PostgreSQL-Instanz, und die Konsole steht hinter dem üblichen Single Sign-on der Box. Die Erreichbarkeit des Brokers im LAN ist bewusst über eine Einstellung geschaltet und standardmäßig auf die Box selbst begrenzt. Typische Einsätze sind die Verwaltung des Gerätebestands einer Organisation und ein prüffähiges Software-Inventar ohne Cloud-UEM. Das Modul ist opt-in und experimentell.
Vaultwarden ist eine alternative, in Rust geschriebene Server-Implementierung der Bitwarden-Client-API, kompatibel mit den offiziellen Bitwarden-Clients und für den Selbstbetrieb ausgelegt. Sie unterstützt nahezu alle wesentlichen Bitwarden-Funktionen, darunter persönliche Tresore, Organisationen, Zwei-Faktor-Authentifizierung und administrative Werkzeuge. Das Projekt wird von der Community gepflegt und ist nicht offiziell mit Bitwarden, Inc. verbunden. Derzeit als experimentelles Modul enthalten.
Infisical ist ein Secrets-Management-Dienst für Entwicklerinnen und Entwickler mit Projekt-/Umgebungs-Scoping über CLI und REST-API. Im Stack nutzen ihn unter anderem KI-Coding-Agents wie OpenHands, um Zugangsdaten zur Laufzeit abzurufen, abgesichert über Authentik-SSO. Derzeit als experimentelles Modul enthalten.
Der Backup-Dienst wird von rzfz.ai als Container gebaut, das eigentliche Werkzeug — docker-volume-backup — stammt von Offen. Es sichert nachts automatisiert und GPG-verschlüsselt alle Datenbanken und Volumes des Stacks, legt vor dem Volume-Snapshot einen Datenbank-Dump an und hält Backups nach einer konfigurierbaren Aufbewahrungsfrist vor.
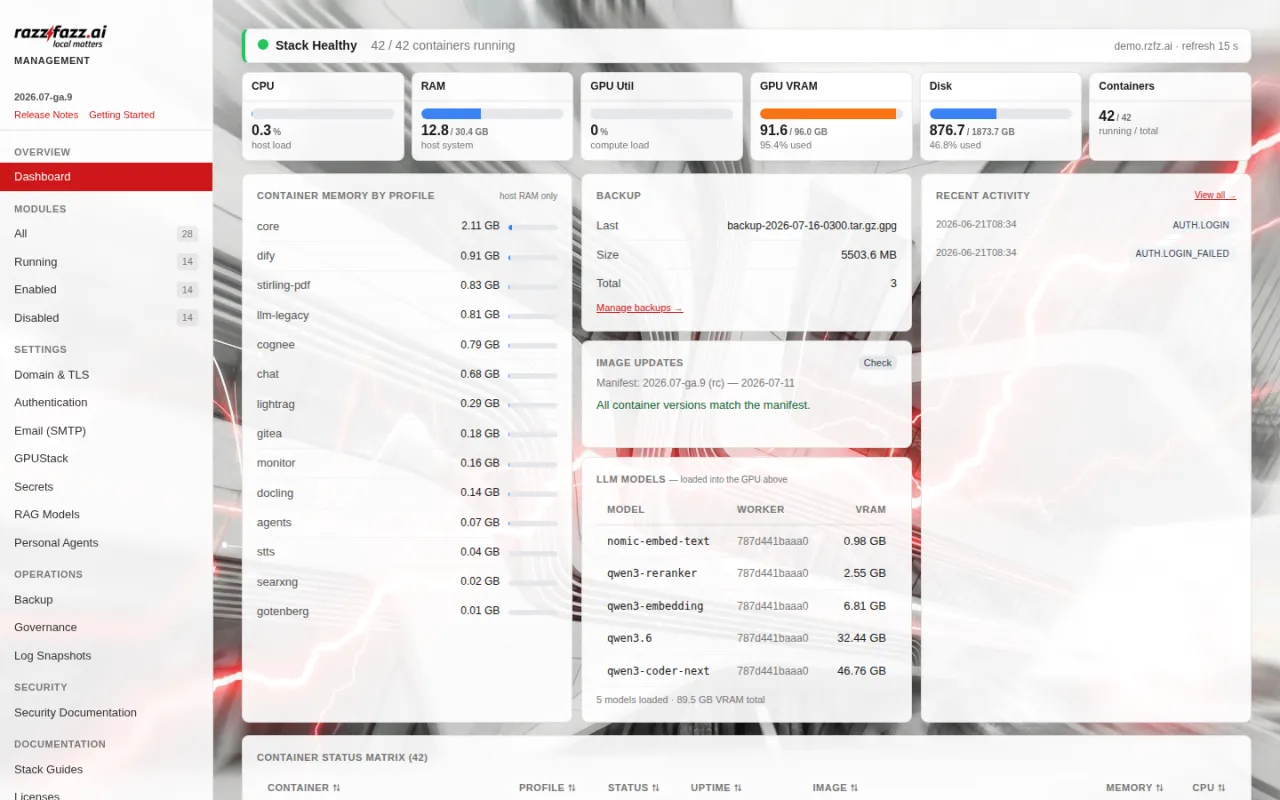
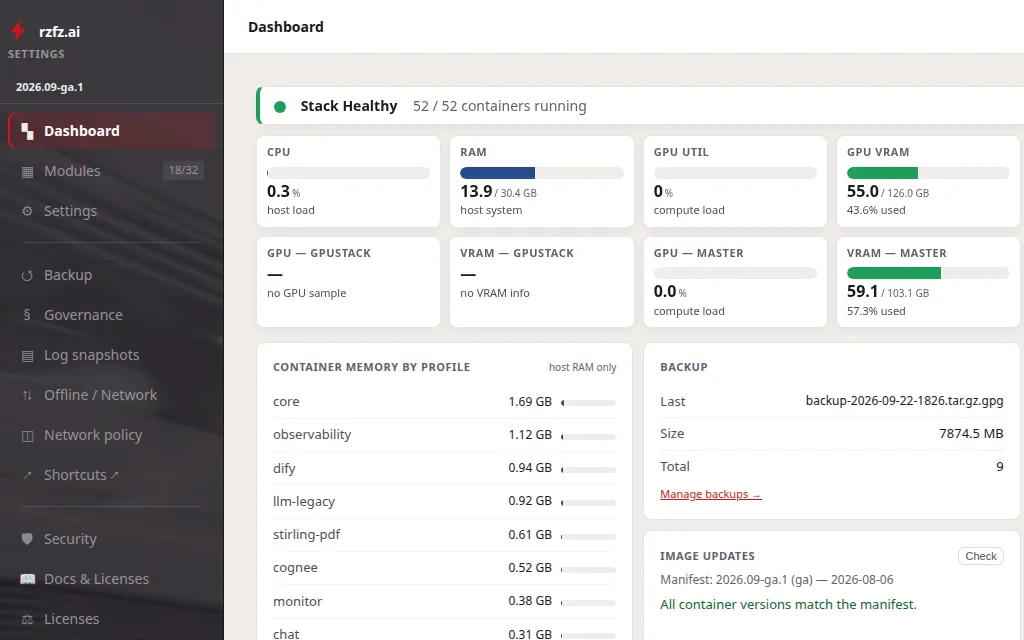
Das Settings-Portal ist die Schaltzentrale der Box für alles, was sonst eine Kommandozeile bräuchte. Module lassen sich einzeln ein- und ausschalten, Einstellungen und Secrets je Modul pflegen, eigene TLS-Zertifikate hinterlegen, Backups anstoßen und wiederherstellen, Log-Schnappschüsse ziehen und im Ernstfall ein Factory-Reset auslösen. Änderungen schreibt es direkt in die Docker-Compose-Konfiguration und wendet sie an, statt sie nur zu protokollieren. Der Zugang liegt hinter dem Single Sign-on der Box und ist auf die Administrationsgruppe beschränkt. Mit 2026.09 wurde das Portal neu gestaltet; es ist der Nachfolger des früheren Config-Portals und führt Hilfe-Center und Lizenzübersicht in derselben Oberfläche.
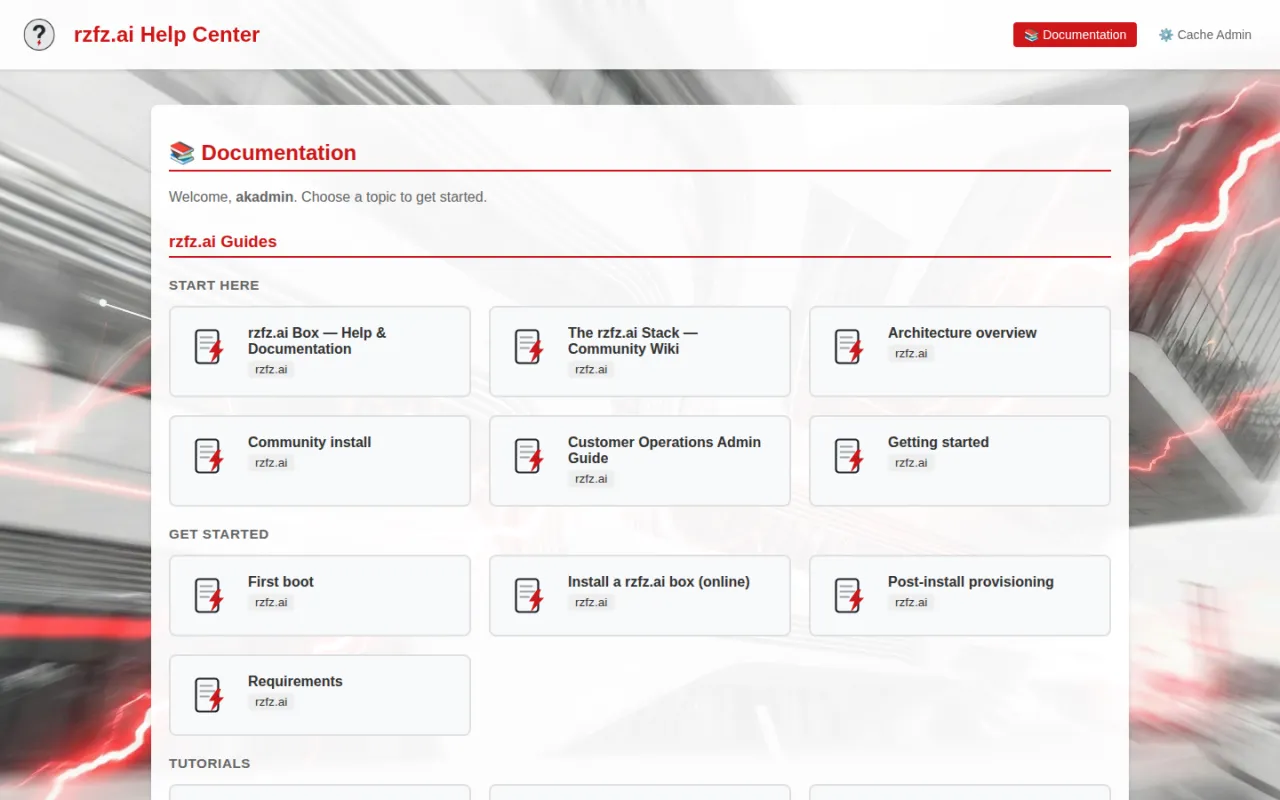
Das Help-Center ist eine von rzfz.ai entwickelte, lokal gehostete Dokumentations-Oberfläche für den Stack. Sie rendert die mitgelieferten Anleitungen und Referenzseiten, sodass Support-Inhalte auch ohne Internetverbindung verfügbar sind.
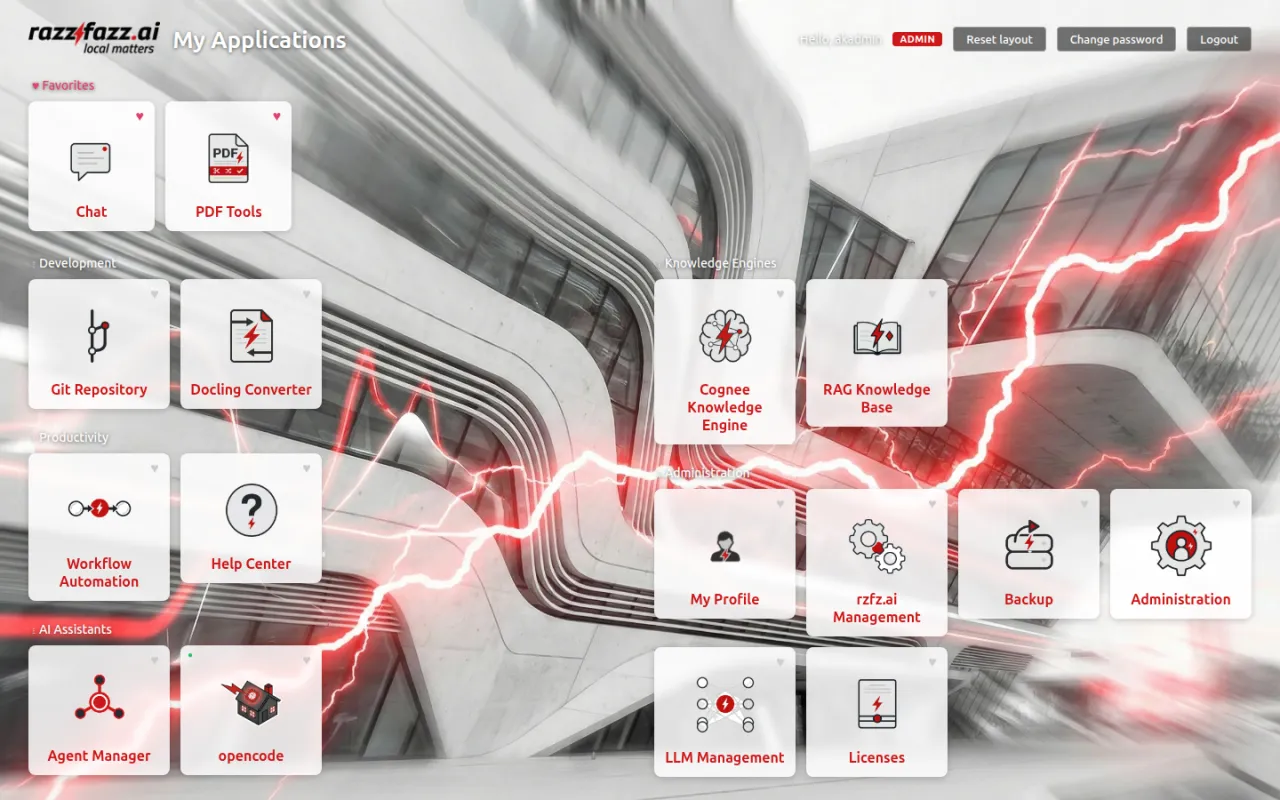
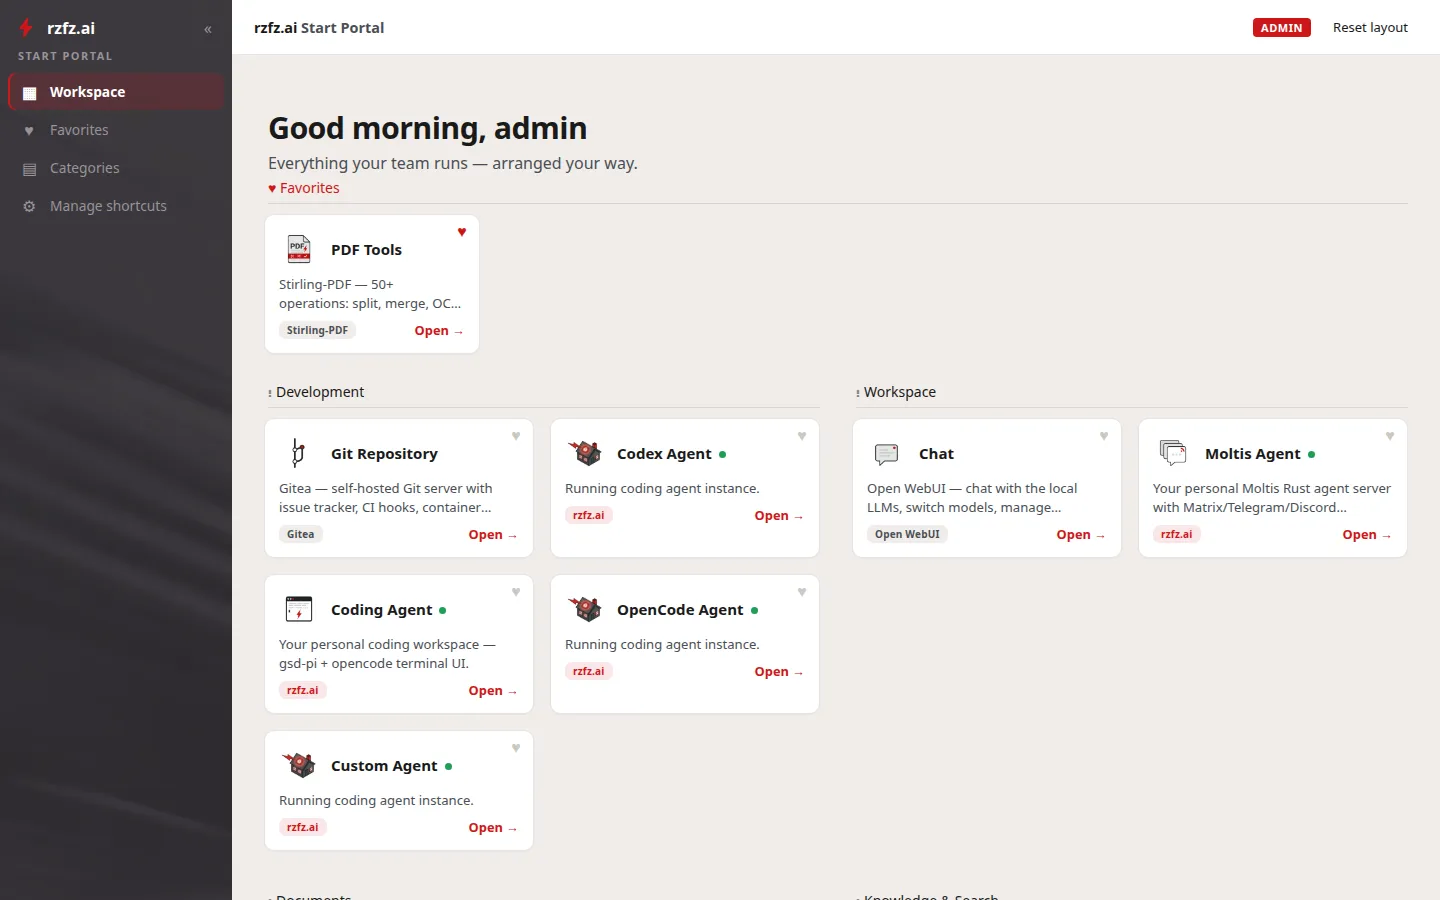
Das Start-Portal ist eine von rzfz.ai entwickelte Landingpage nach dem Login: Es liest die aktivierten Module aus der Compose-Konfiguration aus und verlinkt direkt auf jede freigeschaltete Anwendung.
Autoheal überwacht die Docker-Health-Checks aller Container und startet fehlerhafte Container automatisch neu. Im Stack ist es gezielt für die GPUStack-Familie und den Presidio-Analyzer aktiviert, deren Worker-Prozesse gelegentlich hängen bleiben.
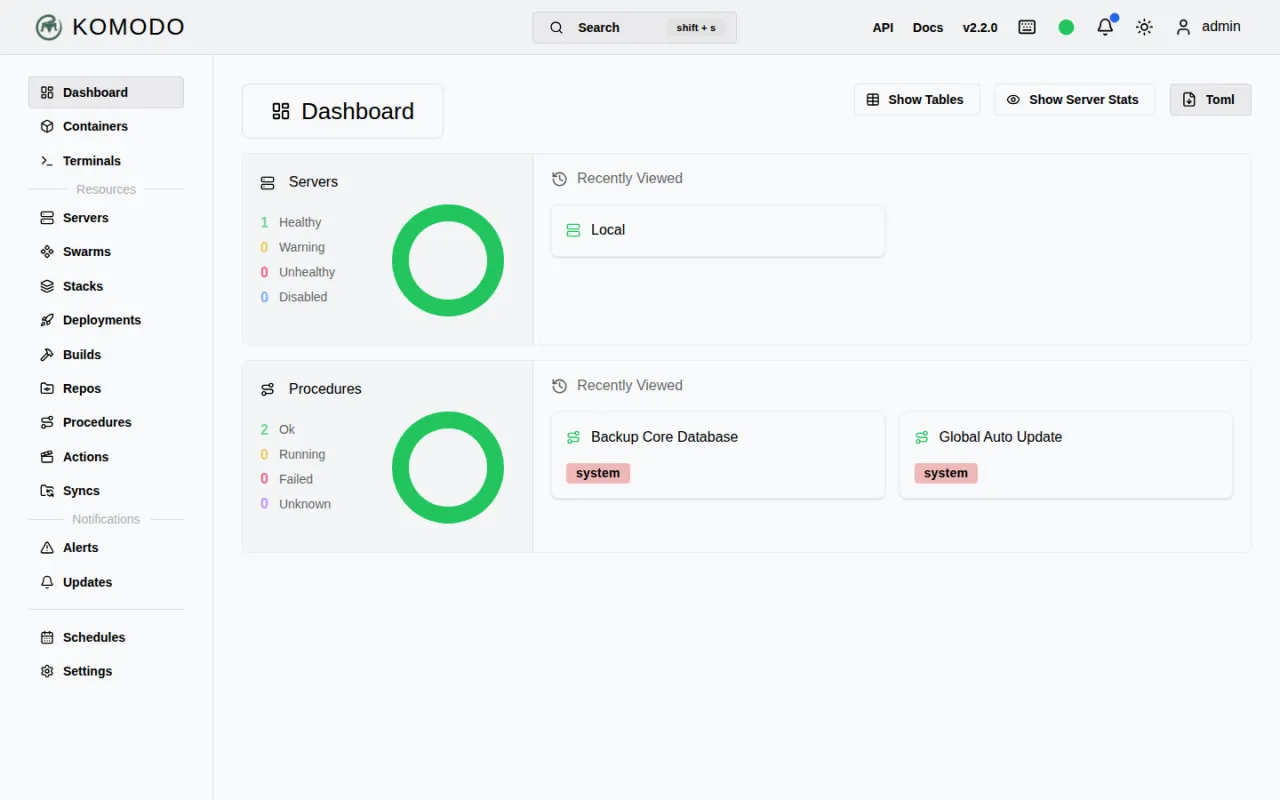
Komodo ist ein Dashboard für Container-Gesundheit, Logs und Neustart-Steuerung. Im Stack überwacht es alle Docker-Compose-Stacks über eine eigene, vom Hauptsystem getrennte Datenbank.
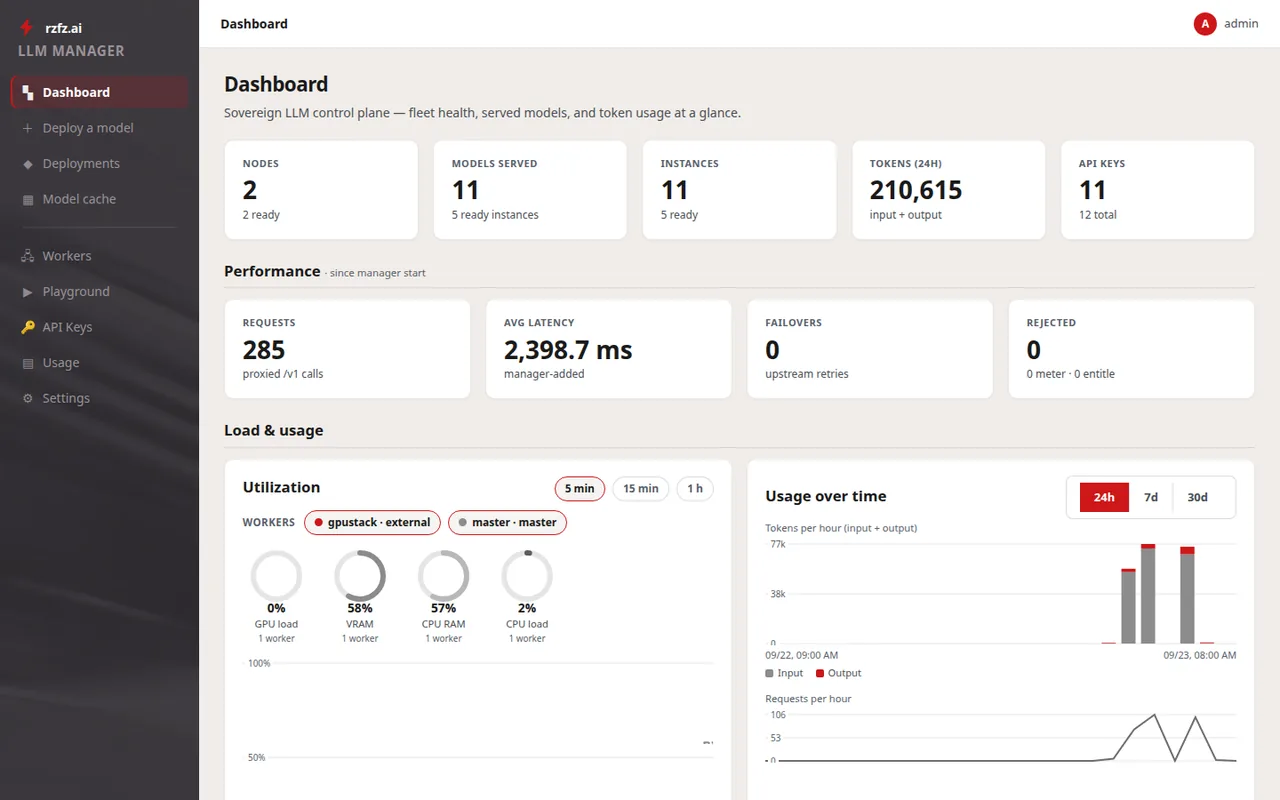
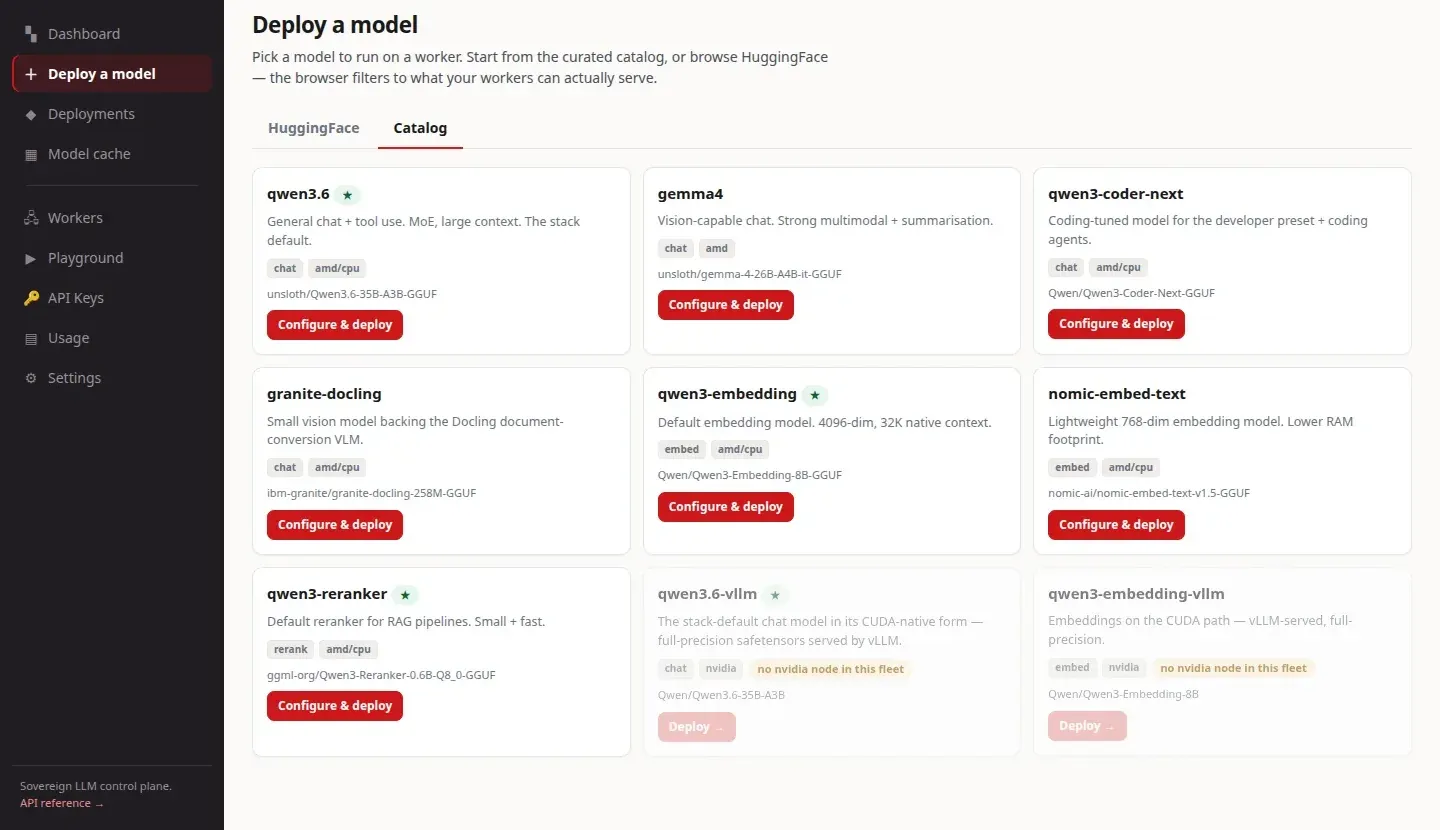
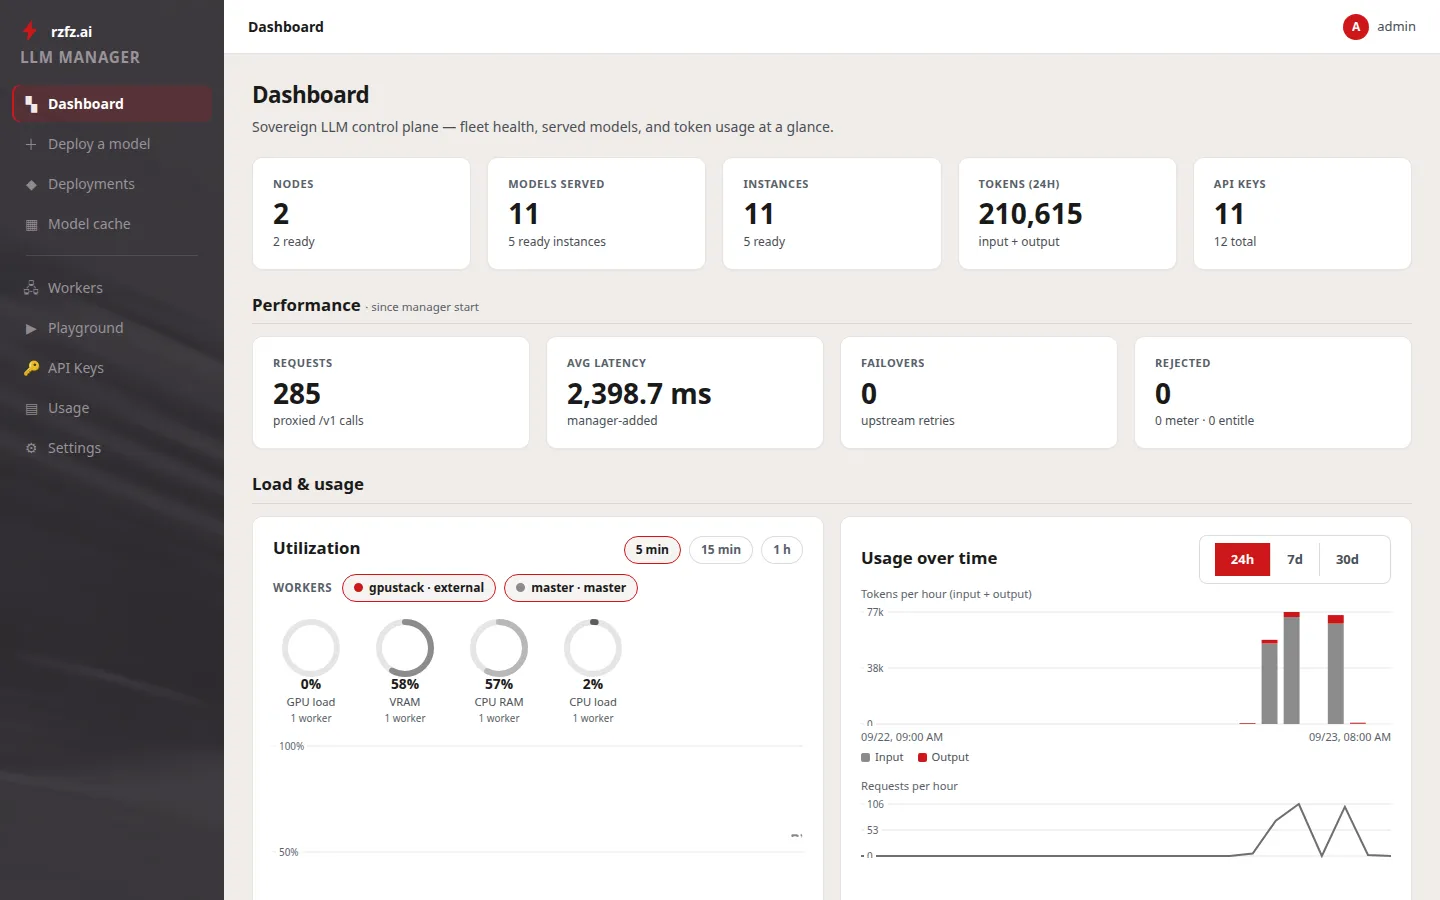
Der LLM-Manager verwaltet eine Flotte: die Box, auf der er läuft, und optional weitere Worker — Rechner, die unter der Kontrolle dieser Box Modelle servieren. Modelle werden aus einem kuratierten Katalog oder direkt aus einer Hugging-Face-Suche auf dem passenden Worker bereitgestellt; vor dem Start prüft eine Zulassungskontrolle den tatsächlichen Speicher-Spielraum des Ziels, sodass ein nicht passender Deploy sofort abgelehnt wird statt Minuten später zu scheitern. Anwendungen sprechen einen einzigen OpenAI-kompatiblen Endpunkt mit API-Schlüssel an, und der Manager leitet jede Anfrage an die Engine weiter, die das Modell serviert — gleich wo in der Flotte sie läuft. Jede Anfrage wird in Tokens (Eingabe, Ausgabe, gecacht) je Schlüssel und Kostenstelle erfasst; eine Währung gibt es im Produkt bewusst nicht. Über die Konsole werden außerdem neue Worker mit einem Einzeiler aufgenommen und freigegeben, für Wartung stillgelegt und Engine-Laufzeiten je Knoten aktualisiert — mit Rollback. Der mitgelieferte Router ist eine gebündelte LiteLLM-Instanz (MIT).
Ein Rechner tritt der Flotte mit einem Einzeiler bei, der die Adresse des Masters, ein einmaliges Aufnahme-Token und den Zertifikats-Fingerabdruck des Masters enthält — der neue Worker prüft kryptografisch, dass er mit dem richtigen Master spricht, bevor er irgendetwas sendet. Danach hält der Worker-Agent die Verbindung: Heartbeats und Metriken zum Manager, Kommandos (Engine laden und entladen) zurück. Er lädt Modellgewichte und Laufzeit-Images ausschließlich per Digest aus der Registry der Box — eine fremde oder vertippte Image-Referenz wird mit sichtbarer Begründung abgelehnt. Jeder Worker authentifiziert sich mit einem eigenen Schlüssel, der jederzeit rotiert werden kann. Ein reiner Inferenz-Knoten besteht aus genau zwei Containern — Worker-Agent und Socket-Proxy — hat keine eigenen Portale und wird vollständig vom Master aus verwaltet. Eine Weboberfläche hat der Worker-Agent nicht.
Zot beschreibt sich selbst als skalierende, produktionsreife und herstellerneutrale OCI-native Registry für Container-Images und Artefakte, die ausschließlich auf der OCI-Distribution-Spezifikation aufsetzt; das Projekt ist seit Dezember 2022 CNCF-Sandbox-Projekt und steht unter Apache-2.0. Im Stack ist es die Registry der Box selbst: Sie hält Modellgewichte (GGUF, safetensors, Projektionsgewichte) unter „models/" und Engine-Laufzeit-Images unter „runners/". Worker im eigenen Netz ziehen ohne Zugangsdaten, entfernte Worker authentifizieren sich; jeder Pull wird gegen seinen Digest geprüft, sodass eine beschädigte oder veränderte Datei abgelehnt statt ausgeliefert wird. Genau das macht Flotten in abgeschotteten Netzen möglich: ein Worker ohne Internetzugang bezieht alles vom Master. Eine eigene Weboberfläche wird im Stack nicht als Modulkachel geführt — der Bestand wird über die Registry-Ansicht der LLM-Konsole eingesehen.
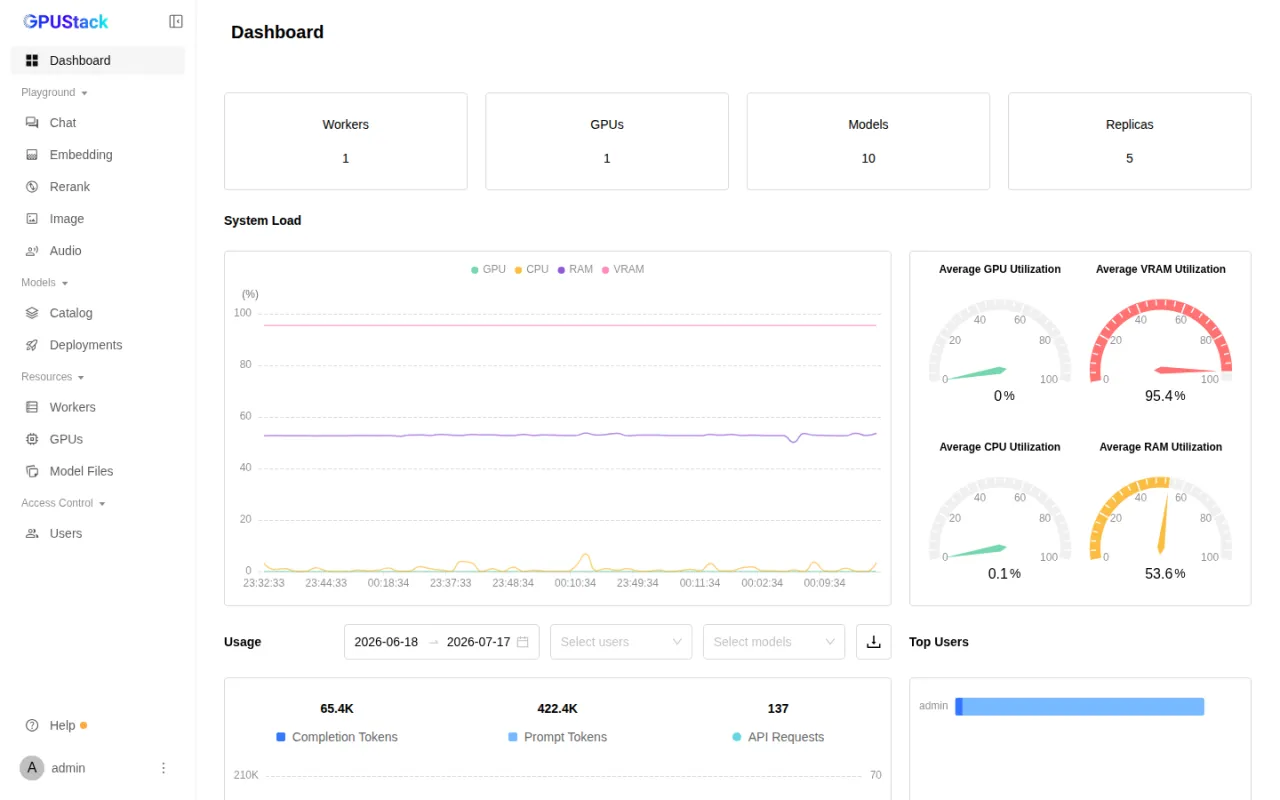
GPUStack ist ein quelloffener GPU-Cluster-Manager für KI-Modell-Serving und GPU-Instanz-Bereitstellung. Es orchestriert Inferenz-Engines wie vLLM, SGLang und TensorRT-LLM über lokale Server, Kubernetes und Cloud-Umgebungen hinweg und deckt ein breites Hardware-Ökosystem ab, von NVIDIA- und AMD-GPUs bis zu Ascend-, Hygon- und weiteren Beschleunigern. Zu den Kernfunktionen zählen automatisierte Engine-Konfiguration, „Day-0"-Unterstützung neu erschienener Modelle sowie Monitoring und Zugriffskontrollen. Im rzfz.ai Stack wird die Inferenz über ein llama.cpp-Backend mit Vulkan (GGUF-Modelle) betrieben. Seit 2026.09 ist GPUStack dort das optionale Legacy-Backend: Es läuft hinter dem LLM-Manager, der als externes Backend darauf verweist, und bleibt für Boxen erhalten, die es eingeschaltet haben — die Anwendungen merken davon nichts, weil sie ohnehin nur noch den Endpunkt des LLM-Managers ansprechen.
Speaches ist ein Speech-to-Text- und Text-to-Speech-Dienst, der Audio lokal über eine OpenAI-kompatible API transkribiert und synthetisiert. Im Stack liefert es Spracheingabe und -ausgabe für Open WebUI und läuft rein intern.
Cognee baut aus Dokumenten und Datenquellen einen Wissensgraphen und beantwortet Fragen per GraphRAG — präziser als reine Vektorsuche. Im Stack dient es als zentrales „Company Brain", auf das Chat, Workflows und Agents über die MCP-Registry zugreifen. Derzeit als experimentelles Modul enthalten.
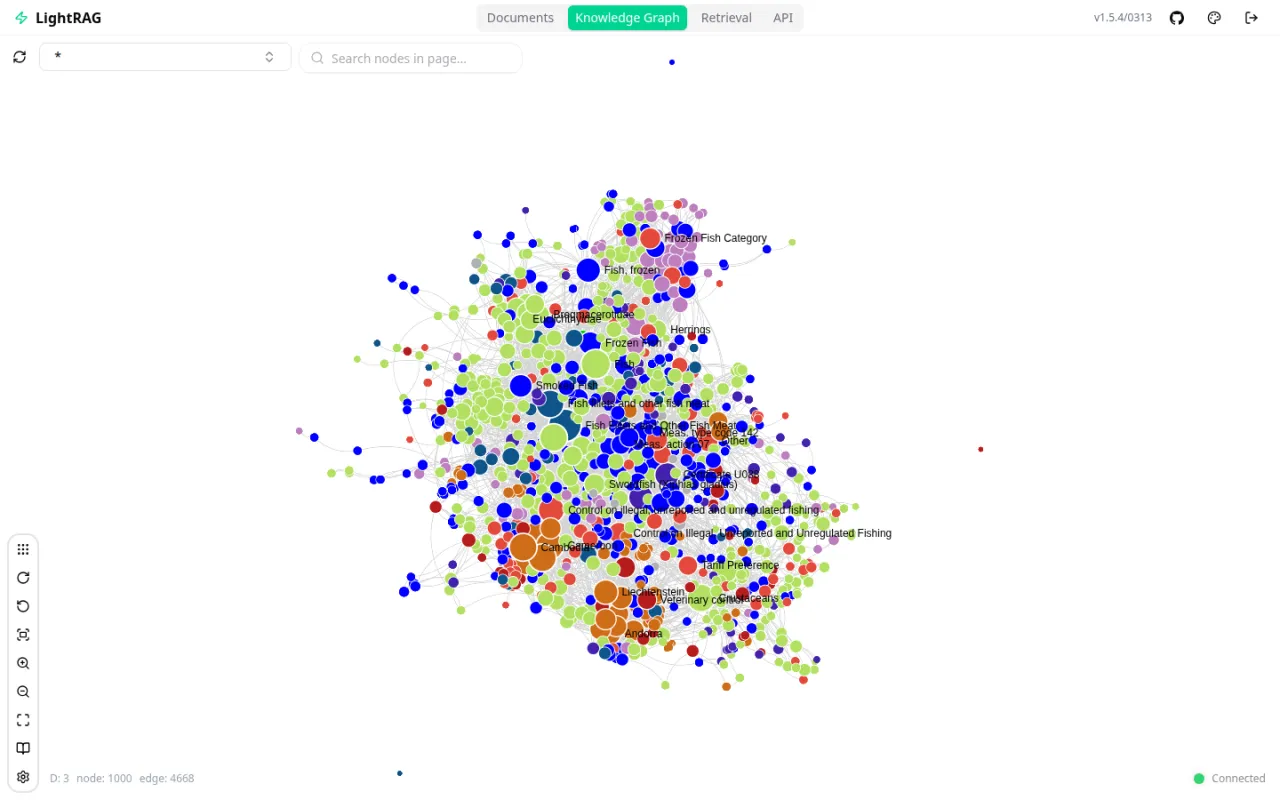
LightRAG ist ein zweistufiges GraphRAG-Framework, das Entitäten und Beziehungen für präzisere Retrieval-Antworten verknüpft. Im Stack nutzt es den LLM-Manager für Embeddings und Graph-Aufbau und dient als leichtgewichtige Alternative zu Cognee für kleinere Wissensbasen. Derzeit als experimentelles Modul enthalten.
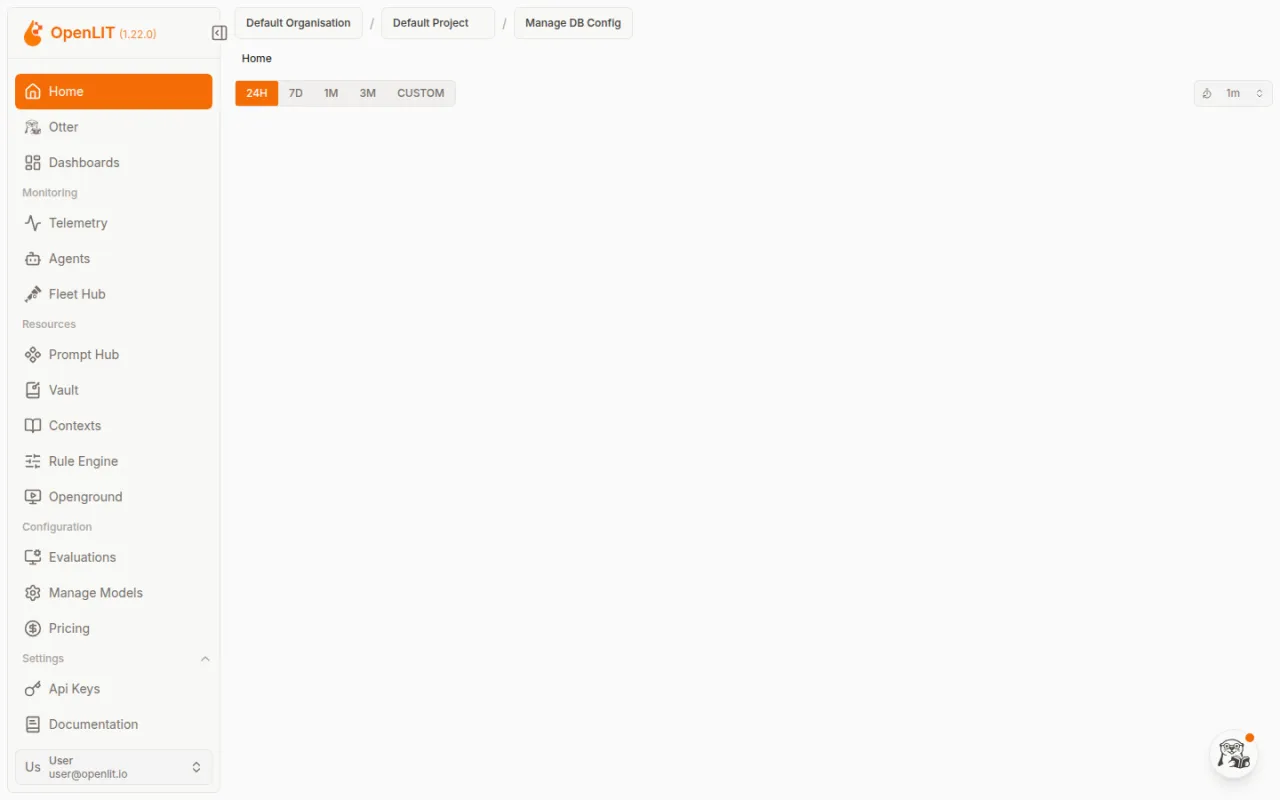
Observability (OpenLIT + ClickHouse) misst Kosten, Latenz, Token-Verbrauch und Prompts für jeden LLM-Aufruf, der durch die Chat-Pipeline läuft. Im Stack ist der Zugriff über eine eigene Authentik-Gruppe beschränkt, und ein PII-Filter schwärzt Prompt- und Antworttext standardmäßig. Derzeit als experimentelles Modul enthalten.
Caddy ist der Reverse Proxy des Stacks und sein einziger externer Eintrittspunkt: Alle Anfragen laufen über die Ports 80/443, TLS-Zertifikate verwaltet Caddy automatisch. Ein Rate-Limit-Plugin schützt die Login-Endpunkte.
PostgreSQL mit der pgvector-Erweiterung ist die relationale Datenbank des Stacks — eine Instanz mit einer eigenen Datenbank pro Modul. Sie speichert die Daten von Open WebUI, Dify, Authentik, GPUStack und weiteren Modulen und liefert zugleich die Vektor-Suche für RAG.
Authentik ist der Identity Provider des Stacks: Single Sign-on, rollenbasierte Zugriffskontrolle und Multi-Faktor-Authentifizierung. Er sitzt als Forward-Auth-Gate hinter Caddy vor jedem Modul und entscheidet anhand von Gruppenmitgliedschaften, wer welche Anwendung erreichen darf.
Valkey ist ein Redis-kompatibler In-Memory-Datenstruktur-Store für Caching und Message-Queues. Im Stack teilen sich mehrere Module eine gemeinsame Instanz, jedes über einen eigenen Datenbank-Index getrennt.
Der SMTP-Relay ist ein Postfix-Mailserver für ausgehende Systemnachrichten. Er läuft ausschließlich intern und versendet Benachrichtigungen und Passwort-Resets für Module wie Authentik und Dify, entweder über einen externen Provider oder direkt per MX-Versand.
Der Docker-Socket-Proxy ist ein gefilterter Zugriffspunkt auf die Docker-API. Module, die Container verwalten müssen — etwa Config-Portal, Backup-Dienst, Agent-Manager oder Authentik — sprechen ausschließlich über diesen Proxy mit Docker, niemals über den ungeschützten Host-Socket.
von razzfazz.ai GmbH entwickelt
Experimentell — neu im Stack und noch nicht lange im Feldeinsatz: funktionsfähig, aber möglicherweise noch fehlerhaft
Ein Stack. Viele Formen.
Leertaste pausiert, Pfeiltasten springen zwischen den Szenen — sobald der Player den Fokus hat.
Text zum Film
Auftakt
Ein Stack. Viele Formen. rzfz.ai: lokale KI auf der Hardware Ihrer Wahl
Eine Box: Schwärzung
Alles auf einer Box. Docling liest, Presidio und das lokale LLM finden personenbezogene Daten. Nichts verlässt das Haus.
Wissens-Chat
Chatten mit Ihrem eigenen Wissen. Vektorsuche plus Wissensgraph, den das lokale LLM aufbaut. Alle Modelle laufen lokal.
Team wächst
Mehr Mitarbeitende? Mehr Boxen. Faustregel für Chat: eine Box je 4–15 Personen. Neue Boxen melden sich selbst an.
Hunderte Support-Mails am Tag? Ein lokaler Workflow sortiert jede: Störung, Anfrage oder Rauschen.
Master auf VM
Den Master auf eine VM legen. Mehr CPU-Kerne und RAM für Dify, Open WebUI, Docling, Cognee und die Datenbank. Die Boxen übernehmen die Inferenz.
Cloud: Kapazität oder Master
Lastspitze? EU-Cloud-GPUs dazunehmen. Der LLM Manager auf Ihrer VM verteilt die Last auf Boxen und Cloud-GPUs (S, M oder L = 1, 2 oder 4).
Oder den Master in der Cloud betreiben. Die Cloud-Instanz übernimmt die Steuerung und orchestriert Ihre Boxen als Worker.
Entwickler
NVIDIA-Leistung dazunehmen. Ihr eigener RTX-PRO-6000-Server oder eine GB10 kommt als Worker dazu.
Entwickler verbinden ihre IDE. Jeder OpenAI-kompatible Client spricht mit llm.<domain>/v1, mit eigenem rzfz-sk-Key.
Coding-Agent 24×7
Ein Coding-Agent, der rund um die Uhr arbeitet. Agent Manager am Master: Harness, lokales Modell und Ihr Gitea. Er schreibt Tests und stellt Pull-Requests.
Ihr eigener Mac
Schon einen Mac Studio? Einfach anschließen. Ihre Hardware: unterstützt, nicht von uns verkauft. Der LLM Manager stellt seine Ollama-Modelle bereit.
Eine Flotte
Unsere, Ihre oder beides. Eine Flotte. Jede App spricht mit einer Tür. Der LLM Manager entscheidet, wo jede Anfrage läuft.
Alles innerhalb der roten Linie läuft in Ihrer eigenen IT. Nur die optionale EU-Cloud läuft außerhalb.
Abspann
Lokal. Open Source. Unabhängig. Sicher. Lokale KI auf der Hardware Ihrer Wahl.
LLM-Manager — eine Konsole für alle Sprachmodelle Ihrer Box
Der LLM-Manager ist die Kontrollebene für die Sprachmodelle Ihrer Box. Er beantwortet an einer
Stelle, welches Modell wo läuft, wer es aufrufen darf und was es verbraucht — und stellt
Anwendungen einen einzigen OpenAI-kompatiblen Endpunkt bereit. Seit 2026.09 ist er die
Vorderseite jeder Box für Inferenz; was die Modelle tatsächlich serviert, sitzt dahinter.
Eine Konsole für Ihre Modelle
Modelle aus einem kuratierten Katalog oder direkt aus einer Hugging-Face-Suche
bereitstellen — auf dem Worker, der dafür passt. Vor dem Start prüft eine
Zulassungskontrolle den tatsächlichen Speicher-Spielraum des Ziels: Was nicht hineinpasst,
wird sofort abgelehnt, statt Minuten später zu scheitern.
Eine Flotte, nicht eine Box
Weitere Rechner treten mit einem Einzeiler bei, der den Zertifikats-Fingerabdruck Ihres
Masters trägt — der neue Worker prüft kryptografisch, mit wem er spricht, bevor er
irgendetwas sendet. Für Wartung stilllegen, Engine-Laufzeiten je Knoten aktualisieren (mit
Rollback) und Schlüssel rotieren: alles aus der Konsole.
Souverän gebaut
Ihre Box trägt ihre eigene Registry. Modellgewichte und Engine-Laufzeiten erreichen die
Worker von dort, bei der Auslieferung gegen ihren Digest geprüft — eine beschädigte oder
veränderte Datei wird abgelehnt statt ausgeliefert. Ein Worker ohne eigenen Internetzugang
bezieht alles vom Master.
Nachvollziehbar
Jede Anfrage wird in Tokens erfasst — Eingabe, Ausgabe, gecacht — je API-Schlüssel und
Kostenstelle. Eine Währung gibt es im Produkt bewusst nicht: Sie sehen den Verbrauch, Ihre
Preise bleiben in Ihrer Buchhaltung.
Katalog & Hugging Face
Agenten-Architektur — pro Benutzer, sandboxed, alles lokal
Der Agent-Manager gibt jedem Benutzer einen eigenen, sandboxed Agenten — erreichbar von
jeder lokalen Chat-Oberfläche, ganz ohne Cloud.
Lokal auf Ihrer Box · keine Cloud
Zugang — nativ, überall lokal
Open WebUI
Web-Terminal(OpenCode)
Matrix
Hermes · Moltispersönliche Agenten
Agent-Managerprovisioniert · pro Benutzer · sandboxed
Pro Benutzer: sandboxed Agent-Instanzen
Sandbox
Agent · Benutzer A
Sandbox
Agent · Benutzer B
Gemeinsame lokale Dienste
Local LLMInferenz
RAG / WissenCognee · LightRAG
DokumenteDocling · Tika
Tools via MCPMCP-Manager → Gitea · Websuche
Neu in 2026.09: das Agenten-Portal
Die persönlichen Agenten jedes Benutzers — Coding-Agents, Assistenten, selbst definierte —
liegen in einer einzigen Ansicht: Live-Status und Öffnen mit einem Klick, für
Coding-Agents dazu die Vorschau des laufenden Entwicklungsservers. Ein Pane öffnet dabei
auf der Oberfläche des Agenten selbst, nicht auf einem rohen Terminal; das Terminal bleibt
als letzter Zugang eine Ebene tiefer erreichbar. Administratoren sehen und steuern die
Agenten aller Nutzer — starten, stoppen, Speicher begrenzen — mit Prüfpfad, und die
Agentenklassen laufen hinter einem optionalen Egress-Proxy, der ausgehende Verbindungen
standardmäßig verweigert. Der Agent-Manager ist derzeit als experimentelles Modul
enthalten.
Was der Stack für Sie tut
7 Kernfähigkeiten, sofort einsatzbereit auf Ihrer eigenen Hardware — jede davon
bereits im Einsatz bei echten Anwendungsfällen.
Local Chat
ChatGPT-Komfort, ohne dass ein Wort das Haus verlässt
Der rzfz.ai Stack — der integrierte Open-Source-Stack für lokale KI-Infrastruktur — deckt
7 Kernszenarien end-to-end ab. Jedes Feature kombiniert mehrere Module zu einem
fertigen Anwendungsfall, komplett auf Ihrer eigenen Hardware.
Local Chat
ChatGPT-Komfort, ohne dass ein Wort das Haus verlässt
Open WebUI ist die zentrale Chat-Oberfläche für alle Modelle auf der Box — mit Retrieval-Augmented Generation, Websuche und Sprachein-/ausgabe in einer Oberfläche. Im Hintergrund nimmt der LLM-Manager jede Anfrage entgegen und lässt sie auf der eigenen GPU beantworten — wo das Legacy-Profil aktiv ist, über GPUStack mit llama.cpp —, sodass jede Anfrage lokal beantwortet wird. Weil Modell, Vektorsuche und Oberfläche auf derselben Infrastruktur laufen, verlässt kein Prompt und keine Antwort das Haus — ganz ohne externe API-Anbindung. In der Praxis dient Open WebUI als Frontend für zentrale Wissensdatenbanken und branchenspezifische RAG-Anwendungen, von der Produktionssteuerung bis zum Außenhandel.
Module: Open WebUI, GPUStack 0.7.1 (optional legacy backend)
Geschäftsprozesse mit KI automatisieren — auf eigener Hardware
Dify orchestriert Geschäftsprozesse als visuelle Workflows — von einfacher Klassifikation bis zu mehrstufigen Dokument-Pipelines mit Freigabeschritten. Jede Node im Workflow läuft gegen die lokalen Modelle des Stacks, sodass sich Automatisierungen ohne Programmierkenntnisse zusammenklicken und direkt gegen echte Geschäftsdaten testen lassen. Weil Orchestrierung und Inferenz auf derselben Box laufen, bleiben sensible Mandanten- und Kundendaten während der gesamten Verarbeitung im Haus. Im Einsatz klassifiziert Dify so bereits Support-E-Mails bei einem IT-Dienstleister, unterstützt Buchhaltungsprozesse in der Steuerberatung und strukturiert Digitalisierungsprojekte im Consulting.
Ein zentrales Company Brain für Agents, Chat und Workflows
Cognee baut einen Wissensgraphen über Ihre Dokumente und Systeme auf und beantwortet Fragen per GraphRAG statt reiner Stichwortsuche — präziser bei komplexen Zusammenhängen und über Dokumentgrenzen hinweg. Im Stack dient es als gemeinsames Gedächtnis, auf das Chat, Workflows und Agents über die MCP-Registry zugreifen, statt dass jedes Modul sein eigenes Wissen vorhält. Weil der Wissensgraph vollständig auf der eigenen Hardware entsteht, bleiben interne Dokumente und Prozesswissen im Haus — Cognee ist derzeit als experimentelles Modul enthalten und wird laufend weiterentwickelt. Bei einem Produktionsbetrieb bündelt es bereits Anleitungen, Störfall-Historie und Prozessdokumentation zu einer zentralen Wissensbasis, die Mitarbeitende einfach per Chat abfragen.
Persönliche KI-Agenten pro Mitarbeiter — ohne Telegram, ohne WhatsApp
Jeder Mitarbeiter provisioniert über den Agent Manager seine eigenen persönlichen Agenten — Hermes als Python-Agent mit persistentem Gedächtnis und über 30 Werkzeugen, Moltis als in Rust geschriebener Agent-Server mit Matrix-Anbindung. Angesprochen werden sie ganz normal über Open WebUI, ohne dass dafür Telegram, WhatsApp oder ein anderer externer Messenger nötig wäre. Weil Agent Manager, Hermes und Moltis auf derselben Box laufen wie die Modelle, bleiben Gedächtnisinhalte und Konversationen vollständig lokal — alle drei Module sind derzeit als experimentelle Bausteine des Stacks enthalten. Damit lassen sich persönliche Assistenten aufbauen, die sich an frühere Anfragen erinnern und eigenständig Aufgaben übernehmen, ohne dass Daten je die eigene Infrastruktur verlassen.
Module: Agent Manager, Hermes, Moltis
Local Coding Agents
Kein Code verlässt die Box
Coding-Agenten laufen im geschützten Container-Terminal auf Box oder Master — mit Zugriff auf das lokale Gitea und die On-Box-Coding-Modelle. Sie übernehmen abgegrenzte Aufgaben wie Testabdeckung erhöhen, Refactorings oder Spezifikations-getriebene Implementierung und stellen ihre Ergebnisse als Merge Requests. Weil Modelle, Code und Git-Server auf derselben Infrastruktur liegen, braucht es weder externe API-Keys noch verlässt eine Zeile Code das Haus. Bei Kunden läuft so bereits ein Agent, der rund um die Uhr die Unit-Test-Coverage erhöht.
Docling, Tika und Gotenberg lesen, konvertieren und interpretieren Dokumente jeder Art — von PDFs und Office-Dateien bis zu gescannten Belegen mit Layout-Analyse. Vision-Modelle auf der eigenen GPU übernehmen die Bilderkennung, während Stirling PDF als Werkzeugkasten für Zusammenführen, Teilen und Konvertieren bereitsteht. Weil die gesamte Pipeline — Erkennung, Konvertierung und Vision-Inferenz — auf derselben Infrastruktur läuft, verlassen Rechnungen, Verträge und andere sensible Dokumente nie das Haus; Docling, Tika und Stirling PDF sind derzeit als experimentelle Module enthalten. Im Einsatz liest diese Pipeline bereits Belege für die Vorverarbeitung in der Steuerberatung und extrahiert eingehende Kundendokumente, bevor sensible Daten geschwärzt werden.
Module: Docling, Apache Tika, Gotenberg, Stirling PDF
Personenbezogene Daten erkennen und schwärzen — in Text und Bild
Microsoft Presidio erkennt und anonymisiert personenbezogene Daten in Dokumenten-Pipelines, bevor sie an andere Module weitergereicht werden — über 30 Kategorien, in Text ebenso wie in Bildern. Der Analyzer identifiziert sensible Stellen, der Anonymizer schwärzt oder ersetzt sie, und der Image Redactor übernimmt dieselbe Aufgabe für Fotos und Scans. Presidio läuft rein intern als Vorverarbeitungsschritt auf derselben Box wie die übrigen Module — personenbezogene Daten werden also geschwärzt, bevor sie überhaupt an ein Sprachmodell gehen; das Modul ist derzeit als experimenteller Baustein des Stacks enthalten. Eingesetzt wird es bereits, um eingehende Kundendokumente zu schwärzen und um bei der Bildanalyse in der Patientenversorgung sensible Gesundheitsdaten vollständig in der Einrichtung zu behalten.
Der Agent-Manager gibt jedem Nutzer eigene, persistente Agenten. Coding-Agenten arbeiten in
einer Sandbox im Stack — der Quellcode verlässt dabei nie die Box.
Lokales LLM
Modelle laufen lokal
Der LLM-Manager betreibt die Sprachmodelle auf Ihrer eigenen Hardware — wo das Legacy-Profil
aktiv ist, auch über GPUStack. Keine Anfrage geht an eine Cloud.
Datenschutz
Personenbezogene Daten bleiben geschwärzt
Presidio erkennt und schwärzt personenbezogene Daten, bevor ein Dokument weiterverarbeitet
wird — automatisiert, lokal und nachvollziehbar.
Dokumente extrahieren
Wissensbasis
PDF-Werkzeuge
Von rzfz.ai entwickelt
Der Stack ist mehr als die Summe seiner Open-Source-Teile: diese Bausteine entwickeln wir
selbst — die First-Party-Schicht, die aus loser OSS ein Produkt macht.
Config-UI
Die Management-UI: der ganze Betrieb, eine Oberfläche
Die von rzfz.ai entwickelte Management-UI ist die Schaltzentrale des Stacks — kein reines
Backup-Werkzeug, sondern ein vollständiges Betriebs-Cockpit: Module ein- und ausschalten,
Secrets verwalten, Updates einspielen, Backups anstoßen, Zertifikate hochladen und im
Ernstfall einen Factory-Reset auslösen.
Start-Portal
Start-Portal: ein Klick zu jedem Modul
Nach dem Login landen Nutzer im von rzfz.ai entwickelten Start-Portal — einer Landingpage,
die automatisch alle freigeschalteten Module verlinkt. Kein Lesezeichen-Wirrwarr, keine
Suche nach der richtigen URL.
Agent-Manager
Agent-Manager: persönliche & Coding-Agenten verwalten
Der Agent-Manager gibt jedem Nutzer eigene, persistente Agenten — inklusive Coding-Agenten,
die in einer Sandbox im Stack arbeiten. Im MCP-Manager legt jeder Nutzer daneben eigene
MCP-Integrationen an und gibt sie für seine Agenten frei.
Eigener Coding-Agent
Ihr eigenes Coding-Agent-Werkzeug einbinden
Wer sein eigenes Coding-Agent-Werkzeug bevorzugt, installiert es als nutzerdefinierten
Coding-Agenten im persistenten Workspace — direkt über den Agent-Manager konfiguriert.
Alle 9 Bausteine im Überblick
Settings Portal
Settings-Portal — zentrale Oberfläche zur Konfiguration des rzfz.ai Stacks
Help Center
Help-Center — lokal gehostete Dokumentation und Support-Artikel für den Stack
Start Portal
Start-Portal — Landingpage mit Links zu allen freigeschalteten Modulen des Stacks
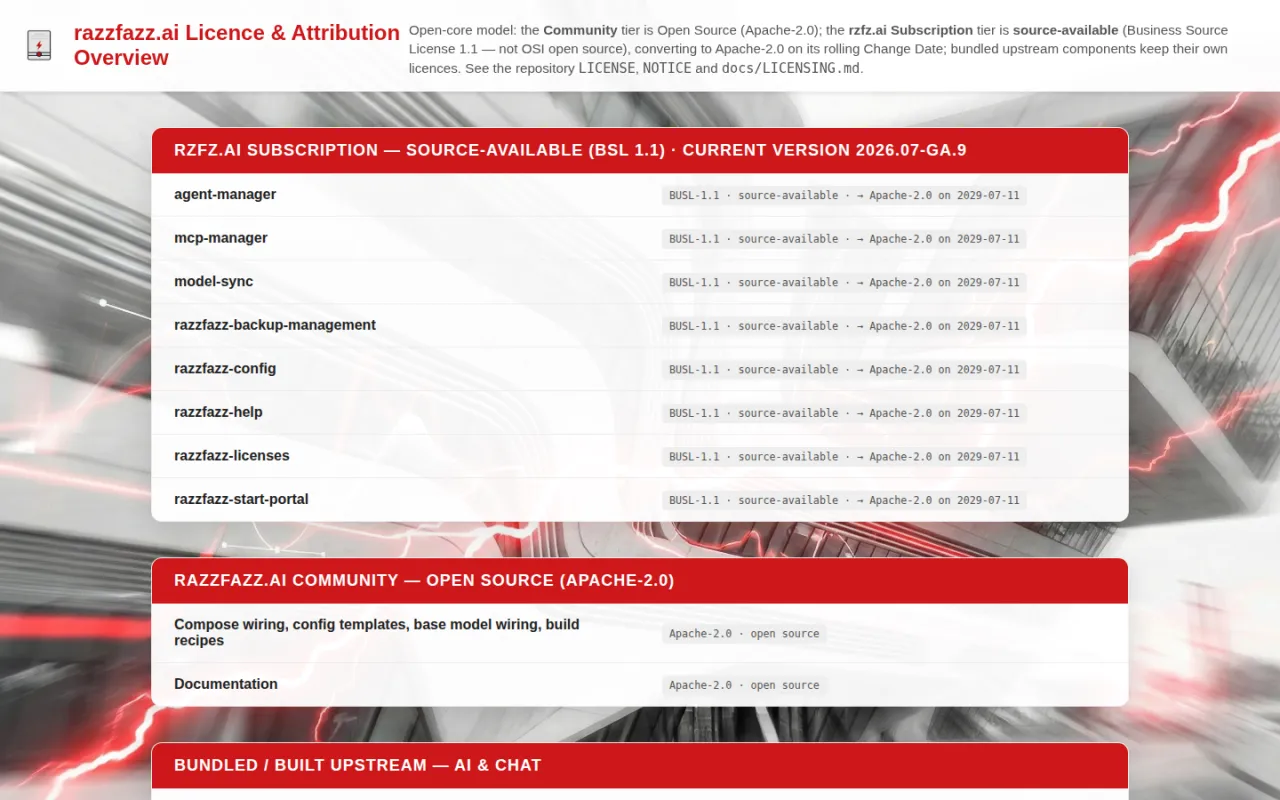
Licenses
Lizenzverwaltung — Aktivierung und Status der freigeschalteten Module und Bundles
LLM Manager
LLM-Manager — eine Konsole für alle Sprachmodelle der Box: bereitstellen, überwachen, Verbrauch erfassen
LLM Worker-Agent
Worker-Agent — startet und überwacht die Inferenz-Engines auf jedem Rechner der Flotte
Agent Manager
Agenten-Portal — persönliche KI-Agenten in einer Ansicht starten, öffnen und überwachen
MCP Manager
MCP-Manager — Registrierung und Freigabe von MCP-Servern für Agents
User Defined Coding Agents
Nutzerdefinierte Coding-Agents — freie Auswahl des eigenen Coding-Agent-Werkzeugs im persistenten Workspace
"Nothing leaves the box unless a module is explicitly configured to reach out."
Härtung & Compliance
Der rzfz.ai Stack — der integrierte Open-Source-Stack für lokale KI-Infrastruktur — ist für
den Unternehmenseinsatz gehärtet: Identität, Netzwerk und Compliance sind von Grund auf
mitgedacht, nicht nachgerüstet.
Identität & Zugriff
Authentik steht vor jedem Modul — kein Dienst ist ohne Anmeldung erreichbar.
Rollenbasierte Zugriffskontrolle (RBAC) und Multi-Faktor-Authentifizierung (MFA) sind
Standard, nicht Zusatzoption.
Netzwerkhärtung
Caddy ist der einzige extern erreichbare Eintrittspunkt — mit Rate-Limiting gegen
Missbrauch.
Der Docker-Daemon ist nie direkt exponiert; ein Docker-Socket-Proxy vermittelt jeden
Zugriff.
Ein SSRF-Proxy filtert ausgehende HTTP-Aufrufe aus Workflows, bevor sie das Netzwerk
verlassen.
Alle Dienst-Ports sind auf localhost gebunden — nichts lauscht auf einer öffentlichen
Schnittstelle.
Compliance
Die Security-Dokumentation enthält Mapping-Tabellen zu NIS2 und ISO 27001 sowie eine
Einordnung nach dem OWASP LLM Top 10. Jedes Release wird mit SBOM und Security-Assessment
ausgeliefert.
Secrets & Backups
Rotations-Tooling für Secrets und GPG-verschlüsselte Backups gehören zum Standardbetrieb —
keine Klartext-Zugangsdaten, keine unverschlüsselten Sicherungen.
Kommerzieller Betrieb
Community-Version, rzfz.ai Subscription und die separat buchbaren Dienstleistungen sind
auf der Enterprise-Seite im Detail beschrieben — inklusive Preisen und dem, was
ausdrücklich nicht enthalten ist.
Der rzfz.ai Stack — der integrierte Open-Source-Stack für lokale KI-Infrastruktur — wird nach
CalVer versioniert und erscheint aktuell in einem monatlichen Release-Zyklus. Die folgende
Liste zeigt alle Releases, neueste zuerst.
Gruppen- und Berechtigungs-Sync von Authentik zu Open WebUI — Zugriffsrechte
im Chat folgen automatisch den Gruppen im zentralen Verzeichnis, statt ein zweites Mal gepflegt
zu werden.
Geprüfter Modell-Katalog — jedes kuratierte Modell auf eine feste Hugging-Face-Revision
gepinnt, deren Digest bei der Aufnahme festgehalten wird; ein Modell außerhalb des geprüften
Bestands zeigt beim Bereitstellen sein Risiko und muss ausdrücklich bestätigt werden.
Agenten-Typen und Vorlagen zentral verwalten — zusammen mit dem Lebenszyklus
einer Instanz, so wie jede andere Anwendung der Box, statt als Sonderfall daneben.
Single Sign-on mit automatisch angelegten Konten — eine neue Kollegin meldet
sich einmal an und findet ihre Zugänge in den Modulen vor, statt dass jemand sie einzeln
anlegt.
Am Horizont
Log- und Metrik-Export in kundeneigene SIEM- und Monitoring-Systeme.
Unterstützung neuer Modellarchitekturen und spekulatives Decoding für weitere
Modelle.
GRC-Bausteine für ISMS-Unterstützung (in Evaluierung).
2026.09-ga
, GA seit 21. September 2026 · Patch 2026.09-ga.1 vom 22. September 2026 — Aktuelles stabiles Release
Ihre Modelle, gemanagt
LLM-Manager und Konsole — Sprachmodelle aus einer Web-Konsole bereitstellen: aus dem kuratierten Katalog oder direkt über die Hugging-Face-Suche, dazu eine Flottenseite für Worker und Nodes, der Modell-Hub, API-Schlüssel mit Limits und Token-Metering je Schlüssel, ein Playground für Chat, Embeddings und Rerank — und ein Dashboard, dessen Kurven den Messwerten folgen.
Ein OpenAI-kompatibler Endpunkt — GPUStack ist nicht länger das Produkt, sondern ein Backend dahinter. Die Adresse, die Sie schon verwenden, antwortet weiter — jetzt aus dem LLM-Manager, mit dessen eigenen Schlüsseln.
Agent-Manager — die vierte App der Ein-Identitäts-Familie: ein Agenten-Portal je Nutzer, das Instanzen statt Typen zeigt, auf der eigenen Oberfläche des Agenten öffnet und Nutzern erlaubt, ihre Agenten zu benennen; Administratoren steuern Start, Stopp und Speicher aller Agenten mit Prüfpfad.
Start-Portal neu — Shortcuts ausgebaut: Favoriten und Kategorien in der Leiste, Kacheln für jedes neue Modul, und kuratierte Ein-Klick-Kacheln: eine Chat-Persona mit voreingestelltem Modell und Prompt, eine Dify-App oder ein externer Assistent mit vorbefülltem Prompt — einmal definiert, auf Authentik-Gruppen zugeschnitten.
Settings-Portal neu — unter eigener Adresse, mit dem informationsorientierten Layout der LLM-Konsole, einem Master-Detail-Bereich für Einstellungen und Schaltern für die neuen Modulprofile.
Help-Center und Lizenzübersicht neu — zweistufige Navigation, lokale Volltextsuche und gespiegelte Upstream-Dokumentation für jedes Modul, dazu eigene Anleitungen für LLM- und Agent-Manager; die Lizenzseite zeigt Tier-Karten, Lizenzfamilien und die vollständigen Lizenztexte, die jetzt im Produkt mitgeliefert werden.
Ein Erscheinungsbild über alle Apps — dieselbe Signatur und dieselbe dunkle Navigationsleiste in Start-Portal, Settings, Lizenzen, Help-Center, LLM-Konsole und Agent-Manager.
Wazuh und OpenUEM — beide experimentell, standardmäßig aus: SIEM/XDR mit Dateiintegritätsüberwachung, Log-Korrelation und Compliance-Zuordnungen; Endpunkt-Inventar, Software-Verteilung und Fernunterstützung für die Flotte.
Chat und Workflows auf neuem Stand — Open WebUI 0.11 mit überarbeiteter Oberfläche, Werkzeugfreigabe durch den Menschen und Sub-Agenten; Dify 1.17 mit datensatzbezogenen Knowledge-API-Schlüsseln, Rückfragen aus Workflows an Menschen und Skill-Verwaltung. Dazu Sicherheitsaktualisierungen für Authentik, Gitea, Valkey, Crawl4AI, Element Web und Vaultwarden.
Erst-Installation robuster (2026.09-ga.1) — ein abgebrochener Modell-Download wird fortgesetzt statt neu gestartet, die Nachinstallation sagt früher, wenn ein Modell endgültig gescheitert ist, statt ihr volles Zeitbudget abzuwarten, und die Bereitschaftsprüfung versteht eine Box mit Internetanbindung.
Vor dem Upgrade — Alles, was die Modell-API Ihrer Box nutzt — den OpenAI-kompatiblen Endpunkt für Sprachmodelle —, braucht nach dem Upgrade einen neuen Schlüssel. Die Adresse, die Sie schon verwenden, funktioniert weiter; nur der Schlüssel ändert sich. Je Verbraucher einen Schlüssel in der LLM-Manager-Konsole erzeugen und eintauschen.
v2026.08-ga
, aktuell v2026.08-ga.15 vom 21. August 2026 — Vorheriges Release
Offline- & Air-Gapped-Betrieb: die Box läuft komplett ohne Internet; Installation und Updates ohne Internet mit der rzfz.ai Subscription.
Offline & Air-Gapped — Modul-Betrieb ohne Internetzugang, Installation und Updates ohne Internet mit der rzfz.ai Subscription: alles, was die Box dafür braucht, liegt vollständig lokal vor, mit Vollständigkeits-Prüfung vor jedem Neustart und optionaler Kernel-seitiger Egress-Versiegelung des Hosts.
Apple-Silicon-Inferenz (optional) — Mac-Rechner lassen sich über ein Gateway als zusätzliche Inferenz-Knoten anbinden.
rzfz.ai Shortcuts — kuratierte Mini-Apps für Fachanwender, verwaltet über das Start-Portal.
Enterprise-Dokumentationsportal — zugriffsgeschützte Kundendokumentation unter docs.rzfz.ai.
Domänenwechsel per Klick — ein geänderter Box-Domainname zieht jetzt vollständig durch: SSO-Provider, Login-URLs und alle Dienste folgen automatisch.
Passwort-Manager gehärtet — Vaultwarden speichert in PostgreSQL (Teil des Standard-Backups), SSO-Login-Probleme behoben, Kompatibilität mit aktuellen Bitwarden-Clients.
Sicherheits- und Aktualitäts-Sweep — u. a. kritischer Gitea-Hotfix (CVE-2026-59774), Updates für Matrix, LightRAG, Valkey und Basis-Images; vier gehärtete interne Auth-Pfade.
Kontinuierlich gehärtet über 15 Patch-Releases; öffentliche Downloads jetzt auf GitHub (github.com/rzfz-ai/rzfz-ai-service-stack).
v2026.07-ga
Open-Core-Lizenzmodell wird öffentlich: Apache-2.0-Community, rzfz.ai Subscription und Coding-Agent-Workspaces
Open-Core-Lizenzmodell veröffentlicht — freie Apache-2.0-Community-Stufe, quellverfügbare BUSL-1.1-Stufe unter der rzfz.ai Subscription, Lizenzübersicht unter license.<domain>, öffentlicher GitHub-Mirror und Community-Wiki
Coding-Agent-Workspaces — persönliche Coding-Agents jetzt als sandboxte Container je Typ (OpenCode, Codex, nutzerdefiniert) mit Live-Preview der Web-App sowie persönlichen MCP-Integrationen und Memory
Dify 1.15.0 — der doppelte SSO-Login-Prompt entfällt
v2026.06-ga
Ein Default-Modell: qwen3.6 mit 1M Kontext für Chat, Coding und Vision
qwen3.6 als einziges Standardmodell für Chat, Coding, allgemeine Aufgaben und Vision bei 1M Kontext — kein Modell-Jonglieren je Rolle mehr
Dokumenten-Q&A funktioniert direkt — Reranker- und Chunking-Defaults für RAG sind vorkonfiguriert
Stabilere Upgrades — Standard- und 2026.04-Upgradepfad validiert, mit Self-Healing und Journaling für den Upgrade-Prozess
Audit-ready Compliance-Tabellen — strukturierte NIS2 (EU 2022/2555) und ISO/IEC-27001:2022-Nachweise im Security-Handbuch
v2026.05-ga
Personal Agents pro Benutzer: Hermes, Moltis und Coding Agents im „My Agents"-Drawer
rzfz.ai Start Portal — Kachel-Launcher mit per-User-Pinning
Neues Modul Crawl4AI und Observability-Profil (OpenLIT + ClickHouse)
Open WebUI ↔ Dify Manifold Pipe
v2026.04-GA
Ein Befehl von Grundinstallation zu vollständig konfiguriertem Stack: razzfazz-post-install.sh
razzfazz-post-install.sh automatisiert GPUStack-Modell-Deployment sowie Open-WebUI- und Dify-Einrichtung in einem Schritt
Zwei experimentelle RAG-Module: LightRAG (graph-basiert) und Cognee mit FalkorDB
Verschlüsselte .env-Snapshots vor jeder Konfigurationsänderung; Fix für AMD-GPU-Inferenz
Der rzfz.ai Stack — der integrierte Open-Source-Stack für lokale KI-Infrastruktur —
unterstützt ausschließlich Ubuntu 26.04 LTS als Betriebssystem. Für jedes Einsatzprofil gilt
derselbe Anspruch: Wir nennen die Grenzen, bevor Sie sie finden.
rzfz.ai Box
AMD Strix Halo (Ryzen AI MAX+), 128 GB Unified Memory
Nur AMD-Inferenz — kein NVIDIA/CUDA-Pfad auf der Box
vLLM auf Strix Halo derzeit nicht unterstützt (Produktion: llama.cpp via Vulkan)
Das 32-GB-Container-Budget begrenzt, wie viele Module gleichzeitig laufen
Eine intensive Agent-Loop zur Zeit — Richtwert ~1 Box je 6–10 Mitarbeiter
Eigener Server / VM ohne GPU
Beliebiger Ubuntu-26.04-Host, ~16–24 GB RAM
Voraussetzungen
Ubuntu 26.04 LTS, Kernel 7.x
Docker Engine + Compose v2
Einschränkungen
CPU-Inferenz ist langsam — geeignet für leichte oder Batch-Workloads, nicht für interaktive Agents
Als Steuerzentrale delegiert er die Inferenz an GPU-Worker (Boxen oder Cloud)
NVIDIA/CUDA-Server
Ubuntu-26.04-Host mit NVIDIA-GPUs — eigene Hardware oder GPU-Cloud
Voraussetzungen
Ubuntu 26.04 LTS
CUDA-fähige NVIDIA-GPU(s)
Docker Engine + Compose v2
Einschränkungen
Inferenz via llama.cpp auf CUDA, Modelle im GGUF-Format
VRAM-Obergrenze ist eine Budget-, keine Architekturfrage
Cloud-Instanz
Jede Ubuntu-26.04-Cloud-Instanz — mit GPU als Worker, ohne GPU als Steuerzentrale
Voraussetzungen
Ubuntu 26.04 LTS
Docker Engine + Compose v2
Einschränkungen
Datensouveränität hängt vom Cloud-Anbieter ab — für streng lokale Szenarien Box oder eigene Hardware wählen
Gemischte Flotten
Viele Teams kombinieren Profile statt sich auf eines festzulegen: eine Steuerzentrale ohne
eigene GPU orchestriert mehrere rzfz.ai Boxen als lokale Inferenz-Worker und zieht bei
Bedarf zusätzliche Cloud-GPU-Worker für Lastspitzen hinzu. So bleibt der Kernbetrieb lokal —
für Spitzenlast werden aus der Cloud Ressourcen dazugebucht, ohne allerdings die
Datensouveränität aufgeben zu müssen. Passende Kombinationen finden Sie unter Bundles.
Was brauchen Sie? Welches System haben Sie?
Tippen Sie eine Aufgabe oder Ihr System — wir sagen ehrlich, wie es zum Stack passt.
Wie Integration bei uns funktioniert
Vorverdrahtet
Ein Modul im Stack deckt es bereits ab — sofort einsatzbereit, ohne Zusatzaufwand.
Dify-Plugin
Der Dify Marketplace deckt es ab — der Stack erbt es automatisch. für Techniker
REST / MCP
Spricht Ihr System REST oder MCP, ist es direkt anbindbar — ohne Umweg.
Custom · von uns gebaut
Lokale, nischige Branchensoftware, die in keinem Katalog steht — genau dafür bauen wir
die Integration.
Chat / Assistent
Vorverdrahtet
Vorverdrahtet — Open WebUI liefert ChatGPT-Komfort, vollständig lokal.